

دستیار هوش مصنوعی جاباما را در نیمه اول سال ۱۴۰۵ راهاندازی کردیمِ قابلیتی که میتوان آن را نوعی نوآوری مخرب (disruptive innovation) در برابر جستوجوی کلاسیک جاباما دانست.
داستان جاباما AI را با یک نمونه درخواست جستوجو برای رزرو یک اقامتگاه شروع میکنم:
«برای آخر هفته بعد، یک ویلای لوکس و استخردار با قیمت مناسب نزدیک ماسال برای هشت نفر پیدا کن.»
فرض کنید میخواهید یک Discovery Agent بسازید. در نگاه اول تقریباً به شکل خندهداری ساده به نظر میرسد. با چند خط پایتون میتوانید ابزارهای search و present_result را به یک LLM بدهید، درخواست کاربر را همراه با یک پرامپت سیستم به آن پاس بدهید، بگذارید در یک حلقهی ایجنت اجرا شود، نتایج را نمایش دهید و کار تمام است. پس مشکل کار کجاست؟
ایجنت ساده
اولین نسخه از Jabama AI که در پروداکشن امتحان کردیم، اساساً همین بود. یک حلقهی ایجنت ساده، ابزارهایی برای کار با سرویس جستجو و سرویسهای دیگر، و راهی برای نمایش نتایج به کاربر. به نظر میرسید خوب کار میکند. در تئوری، میتوانست هر چیزی را که کاربر میخواست پیدا کند (همهی این ابزارها را دارد، پس مسلماً میتواند کل فضای جستجو را بگردد و چیزی را که کاربر میخواهد پیدا کند، نه؟)، اما در عین حال گران بود، چندان قابل اعتماد نبود و گاهی هم خیلی کُند عمل میکرد. در ادامه میگوییم از اجرای این ایجنت در پروداکشن چه چیزهایی یاد گرفتیم و این مشکلات را چطور حل کردیم.
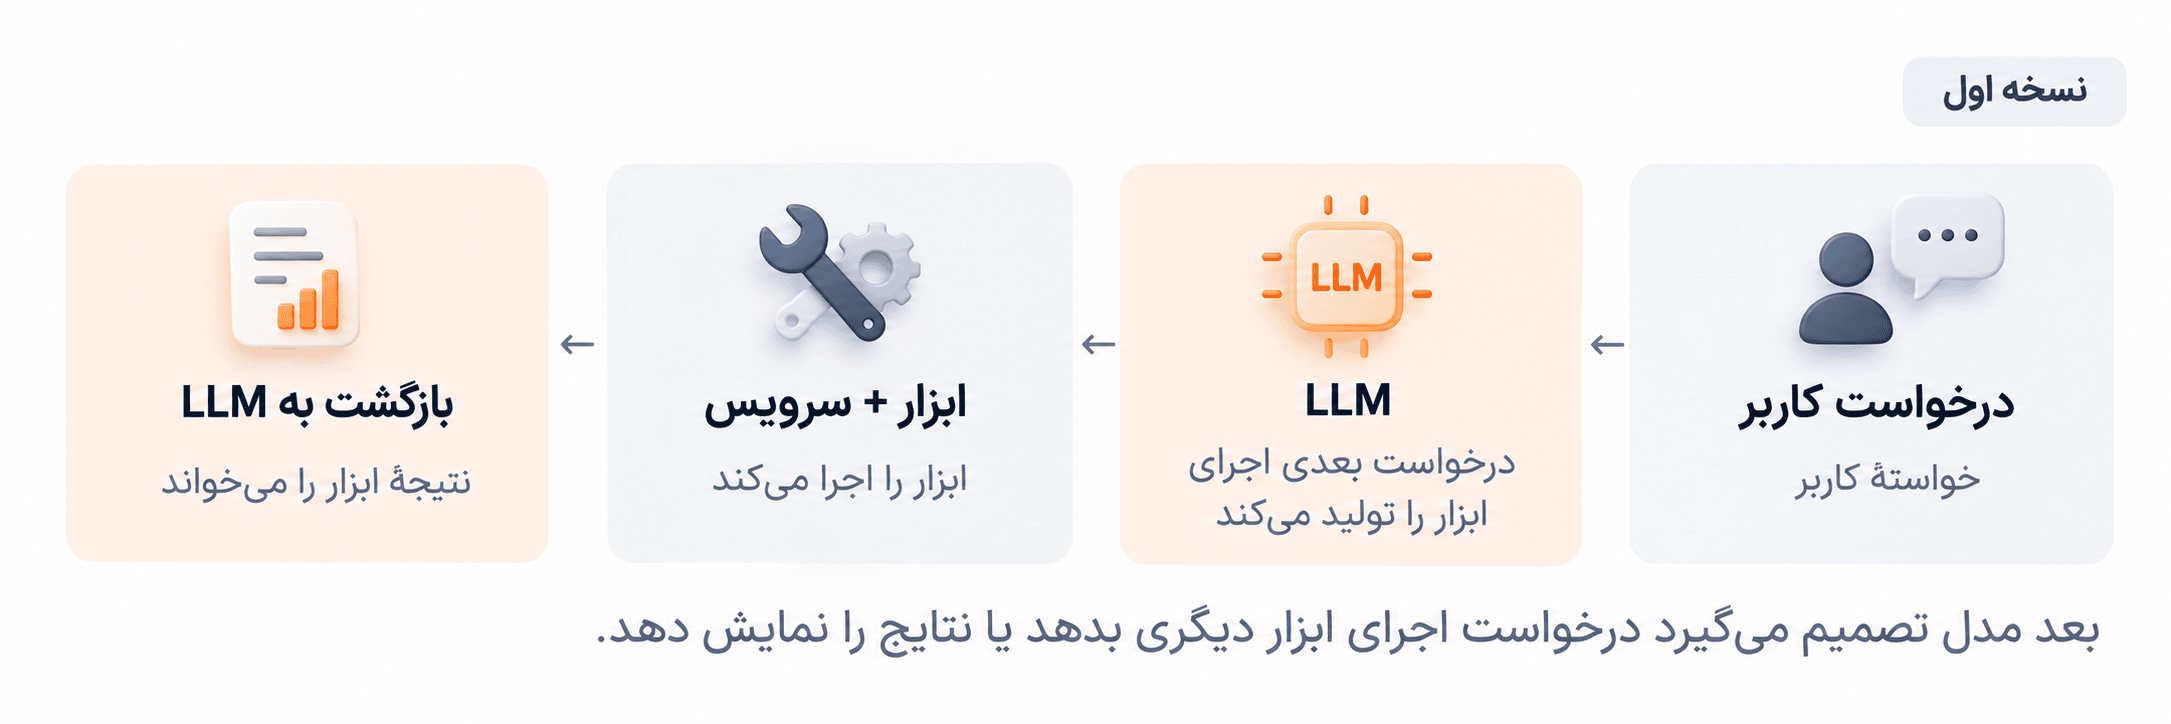
در واقع در این حالت، مدل تعیین میکند جستجو چند نوبت طول بکشد.
از ایجنت ساده چه یاد گرفتیم؟
قابل اعتماد کردن ایجنت نیاز به برنامهریزی دارد
آیا قابل اعتماد کردن ایجنتهای LLM از قابل اعتماد کردن کد معمولی سختتر است؟ بله، اما رفتار مدل، فقط بخشی از مسئله است. با بیشتر شدن تعداد کامپوننتهایی که ممکن است دچار خطا شوند، سیستم کمتر قابل اعتماد میشود. سیستمهای ایجنتی هم معمولاً کامپوننتهای زیادی دارند.
Rtotal = R1 × R2 × R3 × … × Rn
این مدل ساده فرض میکند همهی مراحل برای موفقیت لازم هستند و ارورها هم مستقل عمل میکنند، همچنین retryها را هم در نظر نمیگیرد.
یک حلقهی ایجنت با چند نوبت شامل کامپوننتهای زیر است که هر کدام از آنها میتوانند به شکل متفاوتی دچار خطا شوند:
- ۱. ارسال درخواست به LLM (timeoutها، مشکلات روتینگ شبکه و ...)
- ۲. تولید درخواست اجرای ابزار توسط LLM (احتمال غیرصفر تولید ورودی نامعتبر برای ابزار توسط LLMها) × تعداد درخواستهای اجرای ابزار در هر نوبت
- ۳. فرایند اجرای ابزار (بیشتر ابزارها برای دریافت یا تغییر داده به سرویسهای خارجی وابستهاند) × تعداد درخواستهای اجرای ابزار در هر نوبت
- ۴. ارسال دوبارهی درخواست به LLM، این بار همراه با نتایج ابزار (همان خطاهای شمارهی ۱) × تعداد درخواستهای اجرای ابزار در هر نوبت در بدترین حالت؛ اگر مدل بتواند در یک نوبت چند درخواست اجرای ابزار تولید کند، تعداد دفعات ارسال نتایج ابزار به LLM کمتر میشود.
اینها فقط نقاطی هستند که ممکن است هنگام I/O دچار ارور شوند. نرمافزاری که هرکدام از این مراحل را اجرا میکند هم نرخ خطای خودش را دارد؛ نرمافزاری که در حالت ایدهآل باید کاملاً قابل اعتماد باشد، اما در واقعیت تقریباً هیچوقت اینطور نیست.
هزینهی ایجنت بهراحتی میتواند از فایدهاش بیشتر شود
در تجربهی ما، بخش عمدهی هزینهی LLM مربوط به ورودی بود. هزینهی خروجی یا reasoning هم بهندرت به هزینهی ورودی نزدیک میشد. پس چطور به unit economics معقولی برای یک محصول مبتنی بر LLM برسیم؟
کش ورودی، اصلیترین روش ما برای کاهش هزینه است. هزینه و رفتار کش بین پروایدرها و مدلها فرق میکند، اما در ترکیب مدلها و پروایدرهایی که ما استفاده کردیم، ورودی کششده گاهی حدود ۱۰ برابر ارزانتر از ورودی کشنشده بود. برای پایین نگه داشتن هزینهی هر سشن، باید prefix ثابتی داشته باشیم که بتوانیم آن را بین سشنها دوباره استفاده کنیم؛ هرچند ثابت بودن prefix، تضمین کننده cache hit نیست. برای همین، نمیتوانیم فقط به implicit caching تکیه کنیم. پس راهحل چیست؟
ساختن تجربهی کاربری خوب با ایجنت از حالت عادی هم سختتر است
وقتی ایجنتی میسازیم که کاربر مستقیم با آن کار میکند، محدودیتهای سرعتی داریم که در کاربردهایی مثل ایجنتهای کدنویسی نداریم. دولوپرها به این شیوهی تعامل با مدلها عادت کردهاند: یک ایجنت را راه میاندازند، هر چند وقت یکبار کارش را بررسی میکنند و سر فرصت نتیجه را میگیرند. اما در محصولی که کاربر مستقیم با آن کار میکند، با جستجوی سادهای رقابت میکنیم که در مقایسه با ورکفلوی ایجنت تقریباً آنی است. به ازای هر ثانیهای که کاربر به صفحهی لودینگ یک ایجنت نگاه میکند، درصدی از کاربران محصول را ترک میکنند؛ این اساساً بدترین سناریوی ممکن است. هزینهی LLM را پرداخت کردهایم، اما کاربر قبل از اینکه فرصتی برای خرید داشته باشد، محصول را ترک کرده است.
اما چطور ایجنت را سریع کنیم؟ استفاده از یک مدل سریع مثل Gemini Flash Lite کافی است؟ در بدترین حالت، زمان کجا صرف میشود؟
معمولاً بیشتر زمان انتظار کاربر صرف نوبتهای مدل میشود. این زمان هم به سرعت مدل (استفاده از مدلهای کندتر از یک آستانهی مشخص تقریباً غیرممکن است) و هم به هوش آن بستگی دارد. مدلهای باهوشتر و کندتر اغلب با نوبتهای کمتری به نتایج درخواستی کاربر میرسند و در نتیجه زمان انتظار کاربر را کاهش میدهند. در تجربهی ما، مدلهای کوچکتر هم در تولید درخواستهای اجرای ابزار بیشتر خطا میکردند؛ این خطاها تعداد نوبتها و زمان انتظار را بیشتر میکرد. مسئله به سادگیِ انتخاب سریعترین مدل نیست.
چطور دامین جستجوی خود را به مدل آموزش میدهید؟ نیازهای کاربر چطور؟ intentهای رایج کاربران، تمام ترکیبها و رفتارهایی که کاربر از یک ایجنت فعال در این دامین انتظار دارد؟
شما میتوانید کارهای زیادی با پرامپت سیستم انجام دهید، اما این حجم از داده بسیار بیشتر از آن است که یک پرامپت سیستم بتواند از پس آن برآید، و همهی مدلها در پیروی از دستورالعملها محدودیت دارند. حتی اگر دقیقترین دستورالعملی را بنویسید که در تئوری همهی درخواستهای کاربر را پوشش دهد، ممکن است مدل در عمل بعضی از رفتارها را جا بیندازد. حلقهی ایجنت قرار نیست فقط یک بار در دمو کار کند؛ باید در هزاران سشن و با ورودیها و actionهای مختلف، رفتار منسجمی داشته باشد. پس چطور رفتار مدل را اصلاح کنیم و انتظار داشته باشیم با اضافه شدن دستورالعملهای بیشتر به پرامپت سیستم، همان رفتار دوباره خراب نشود؟
بهینهسازی تقریباً همیشه یعنی کارهای کمتری انجام دهیم؛ اینجا یعنی تعداد نوبتهای حلقهی ایجنت را کم کنیم. بعد از چند ماه اجرای Jabama AI در پروداکشن، این چند نکته را یاد گرفتیم:
- ۱. بیشتر هزینه مربوط به سشنهای طولانی با نوبتهای زیاد است.
- ۲. زیاد بودن نوبتها لزوماً به این معنی نیست که کاربر ورودی زیادی داده است. گاهی یک درخواست واحد از کاربر میتواند مدل را مدت زیادی درگیر جستجوی نتیجهی ایدهآل کند، در حالی که کاربر به احتمال زیاد سشن را بسته است.
- ۳. برای اینکه سشنهای طولانی ممکن باشند، باید تاریخچهی چت را هوشمندانه فشرده کنیم. اما خیلی سخت است این کار را طوری انجام دهیم که مدل گیج نشود و hallucination نکند.
این موضوع به نکتهی قبلی برمیگردد؛ باید ابزارهای کمی در اختیار مدل بگذارید که استفاده از آنها ساده باشد و نتیجهی اجرای موفق یا ناموفقشان هم روشن باشد.
چه کار کردیم؟ قابل اعتماد کردن ایجنت با Effect
خوشبختانه افراد باهوشتر از من راههایی برای کاهش ریسکِ ترکیب کردن تعداد زیادی کامپوننت پیدا کردهاند.
راههای زیادی برای تعریف یک monad یا effect وجود دارد. برای بحث ما، نکتهی مهم این است: Effect نتیجه، ارورهای مورد انتظار و سرویسهای موردنیاز یک computation را در یک type صریح و قابلبررسی نگه میدارد. به این ترتیب، میتوانیم چیزی را که برنامه انجام میدهد از نحوهی اجرای آن جدا کنیم.
// Effect<Intent, IntentResolutionError, IntentResolver>
const resolveIntent = (query: string) =>
  Effect.gen(function* () {
    const resolver = yield* IntentResolver
    return yield* resolver.resolve(query)
  })
اگر به برنامهنویسی imperative عادت دارید، ممکن است این مفهوم گیجکننده باشد. میتوانید effect را primitive قویتری از تابع در نظر بگیرید: نتیجه، نوع ارورها و سرویسهای موردنیاز را در تایپ خود مشخص میکند. این ارورها تا runtime boundary مشخص میمانند؛ جایی که میتوانید از آنها recover کنید، آنها را به خطای دیگری تبدیل کنید یا اجازه دهید promise برگشتی reject شود.
const inspectedIntent = resolveIntent(query).pipe(Effect.either)
// Effect<Either<Intent, IntentResolutionError>, never, IntentResolver>
یا ممکن است هنوز یکی از سرویسهای موردنیاز را فراهم نکرده باشیم:
// IntentResolver must be supplied before the Effect can run.
const runnable = inspectedIntent.pipe(Effect.provideService(IntentResolver, liveIntentResolver))

await Effect.runPromise(runnable)
به این ترتیب میتوانید برنامههایی با هر میزان پیچیدگی را ترکیب کنید. خطاها و سرویسهای موردنیاز هم تا composition layer قابلمشاهده میمانند.
const resolveSearchIntent = (query: string) =>
  resolveDeterministically(query).pipe(
    Effect.catchTag("IntentResolutionError", (error) =>
      error.reason === "timeout" || error.reason === "transport" ? resolveWithModel(query) : Effect.fail(error)
    )
  )
کاهش هزینه با prompt prefix ثابت و ورودیهای داینامیک کمتر
راه اصلی بالا بردن نرخ cache hit و کاهش هزینه این است: دادههای داینامیک موردنیاز بیشتر سشنها را به یک prefix ثابت در پرامپت سیستم منتقل کنیم. مدل این دادهها را از پرامپت میگیرد، نه از ابزارها یا مسیرهای داینامیک دیگر. این خلاف انتظار و نقطهی مقابل روند رایج در ایجنتهای کدنویسی است. در آن الگو، مدل دادههای داینامیک را کشف میکند و پرامپت سیستم به فایلهای skill کوچک تقسیم میشود که فقط هنگام نیاز در اختیار مدل قرار میگیرند، اما نباید فرض کنیم همین رویکرد برای ایجنتهایی که کاربر مستقیم با آنها کار میکند هم مناسب است.
برای مثال، اگر مقداری دادهی تقویم را همیشه در پرامپت سیستم بگذاریم، این دادهها در درخواستهایی که cache hit دارند از کش خوانده میشوند. در تجربهی ما، میانگین هزینهی این روش بسیار کمتر از این بود که ابزار تقویم را به مدل بدهیم تا هر وقت به داده نیاز داشت از آن استفاده کند. این انتخاب، ابزارهای داینامیکی را هم که میتوانیم به مدل بدهیم محدود میکند: تغییر خروجی ابزارهای داینامیک، فرصت استفادهی دوباره از کش را کمتر میکند و مدل ترغیب میشود از ابزارهای موجود در context خود استفاده کند، حتی وقتی نیازی به آنها نیست.
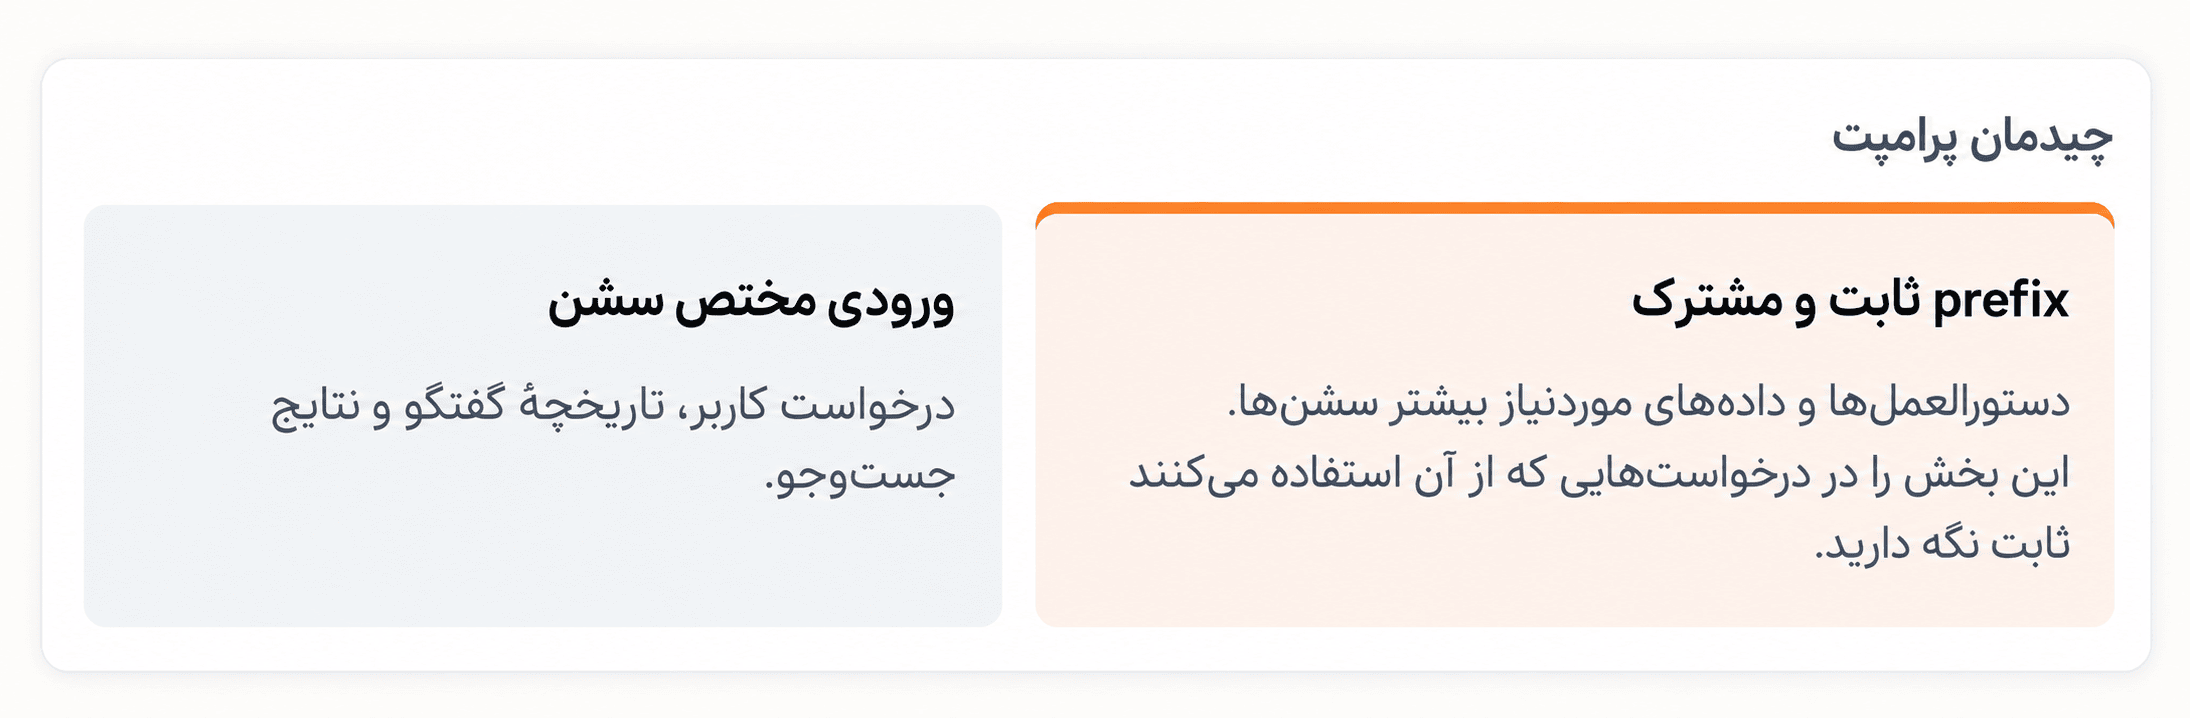
به این ترتیب prefix مشترک میتواند از کش خوانده شود؛ cache hit به پروایدر و وضعیت کش بستگی دارد.
جستجوی سریعتر و نتایج مرتبطتر با منطق deterministic
برای بهتر کردن سرعت و کیفیت نتایج، باید از تنظیم پرامپت سیستم یا پارامترهای مدل فراتر میرفتیم. در نگاه اول، وصل کردن ایجنت به APIهای داخلی کافی به نظر میرسد. اما ایجنت به ابزارهای قویتری نیاز دارد که بتواند با دانش قبلی کمتری از آنها استفاده کند. برای همین، با Rust یک parser عمومی برای زبان طبیعی فارسی ساختیم. parser باید هم دانش دامین جستجو را در خود داشته باشد و هم ورودی مبهم کاربر را هندل کند؛ ورودیهایی که اغلب غلط تایپی، فاصلهگذاری یا نشانهگذاری اشتباه و نامهای نادرست برای چیزها و مکانها دارند.
این parser چهار مرحلهی اصلی دارد:
- ۱. متن را tokenize و normalize میکند.
- ۲. متن را با چند گرامر و parser کوچکتر parse میکند و هر تفسیر ممکن را در یک شاخهی جدا قرار میدهد.
- ۳. شاخهها را بر اساس میزان ارتباط با درخواست، کامل بودن و معیارهای دیگر امتیازدهی میکند.
- ۴. شاخههای کمامتیاز را حذف میکند و باقیماندهها را به availability planner میدهد تا LLM از میان گزینهها انتخاب کند.
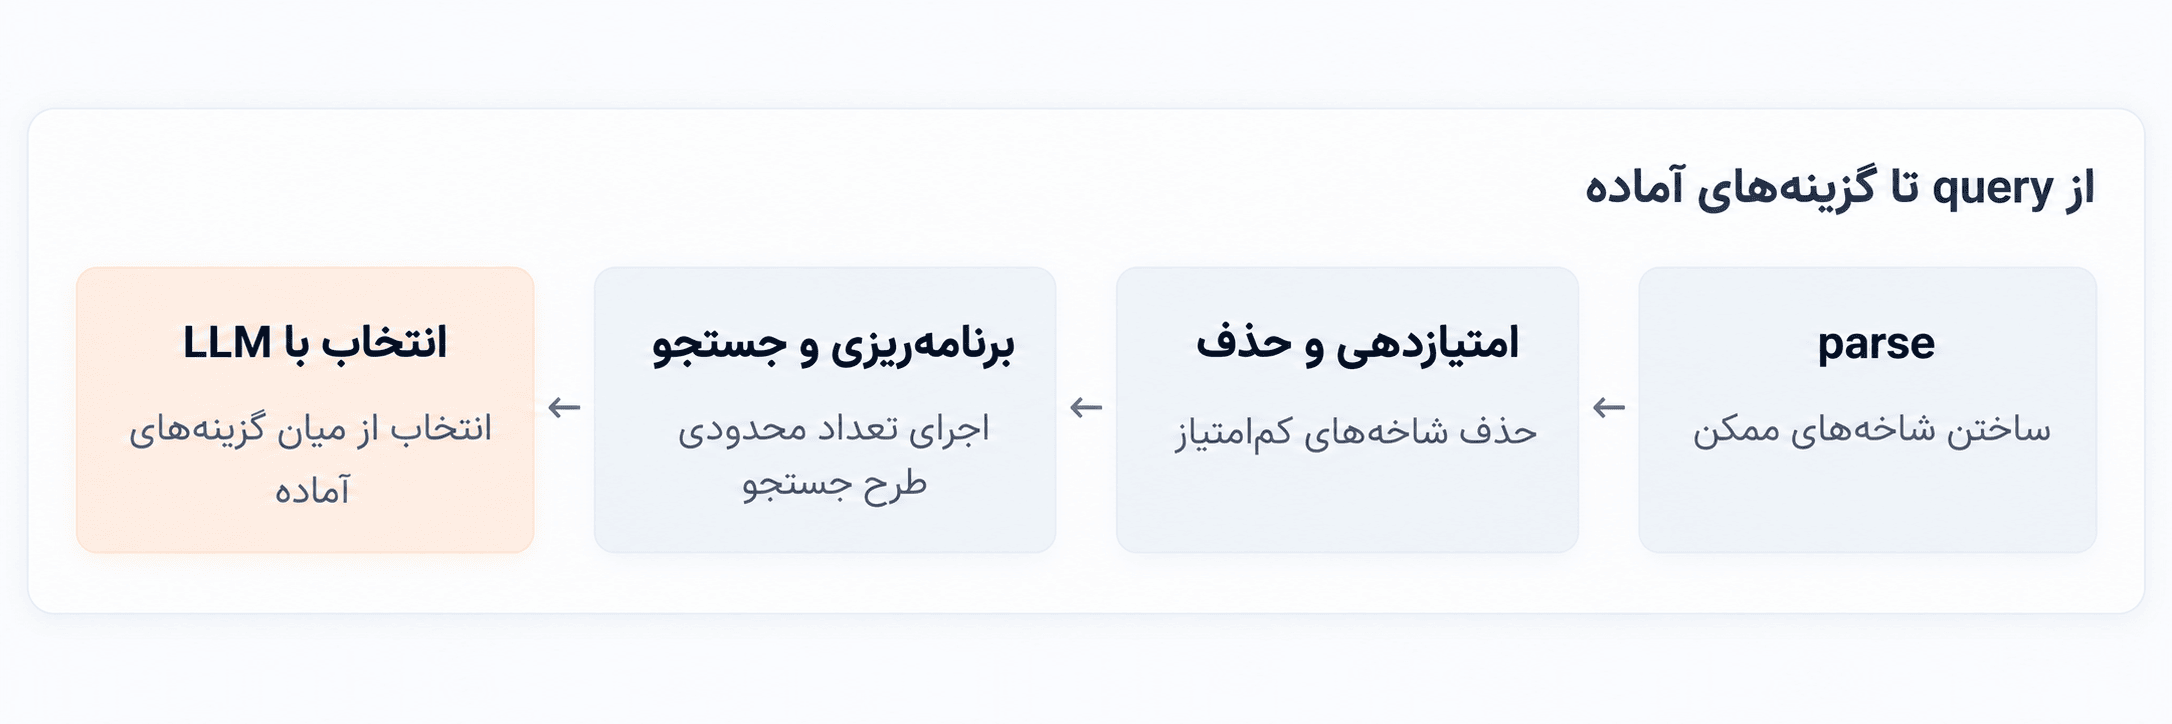
بنابراین parser و planner گزینهها را محدود میکنند؛ بعد مدل تصمیم میگیرد چه چیزی را نمایش دهد.
ابتدا intentهای صریح را resolve کنید
ورودی کاربر را قبل از حلقهی ایجنت، parse کنید تا مدل تاریخها، مکانها، بودجهها یا سایر قیدهای صریح را از دست ندهد.
const routeSearch = (query: string) =>
  Effect.gen(function* () {
    const resolver = yield* IntentResolver
    const intent = yield* resolver.resolve(query)

    return intent.complete ? yield* searchIntent(intent) : yield* continueWithModel(query)
  })
یک ابزار جستجوی ساده در اختیار مدل بگذارید
مدل خواستهی کاربر را بهصورت چند عبارت فارسی به ابزار جستجو میدهد. ابزار با کمک resolver این عبارتها را به پارامترهای جستجو تبدیل میکند؛ مدل نیازی به شناخت ساختار فیلترها ندارد.
search({
  terms: [
    "نزدیک ماسال",
    "ویلای لوکس",
    "استخردار",
    "قیمت مناسب",
    "برای هشت نفر",
    "آخر هفته بعد",
  ],
})
با این کار resolver این عبارتها را به چند SearchPlan معتبر تبدیل میکند. بعد میتوانیم آنها را همزمان اجرا کنیم.
کاهش نوبتها با جستجوی موازیِ محدود
بهجای اینکه مدل در نوبتهای متعدد و بدون حد مشخص فضای جستجو را بررسی کند، مجموعهی کوچکی از طرحهای معتبر جستجو را در کد بسازید و همزمان اجرا کنید.
const searchPlans = (plans: ReadonlyArray<SearchPlan>) =>
  Effect.gen(function* () {
    const search = yield* ProductSearch
    const results = yield* Effect.all(
      plans.map((plan) => search.search(plan)),
      { concurrency: 3 }
    )

    return pickBestNonEmptyResult(results)
  })
نتیجه
حالا سؤال این است: مجموع این راهحلها، در مقایسه با آن ایجنت ساده، چه نتیجهای برای ما داشت؟
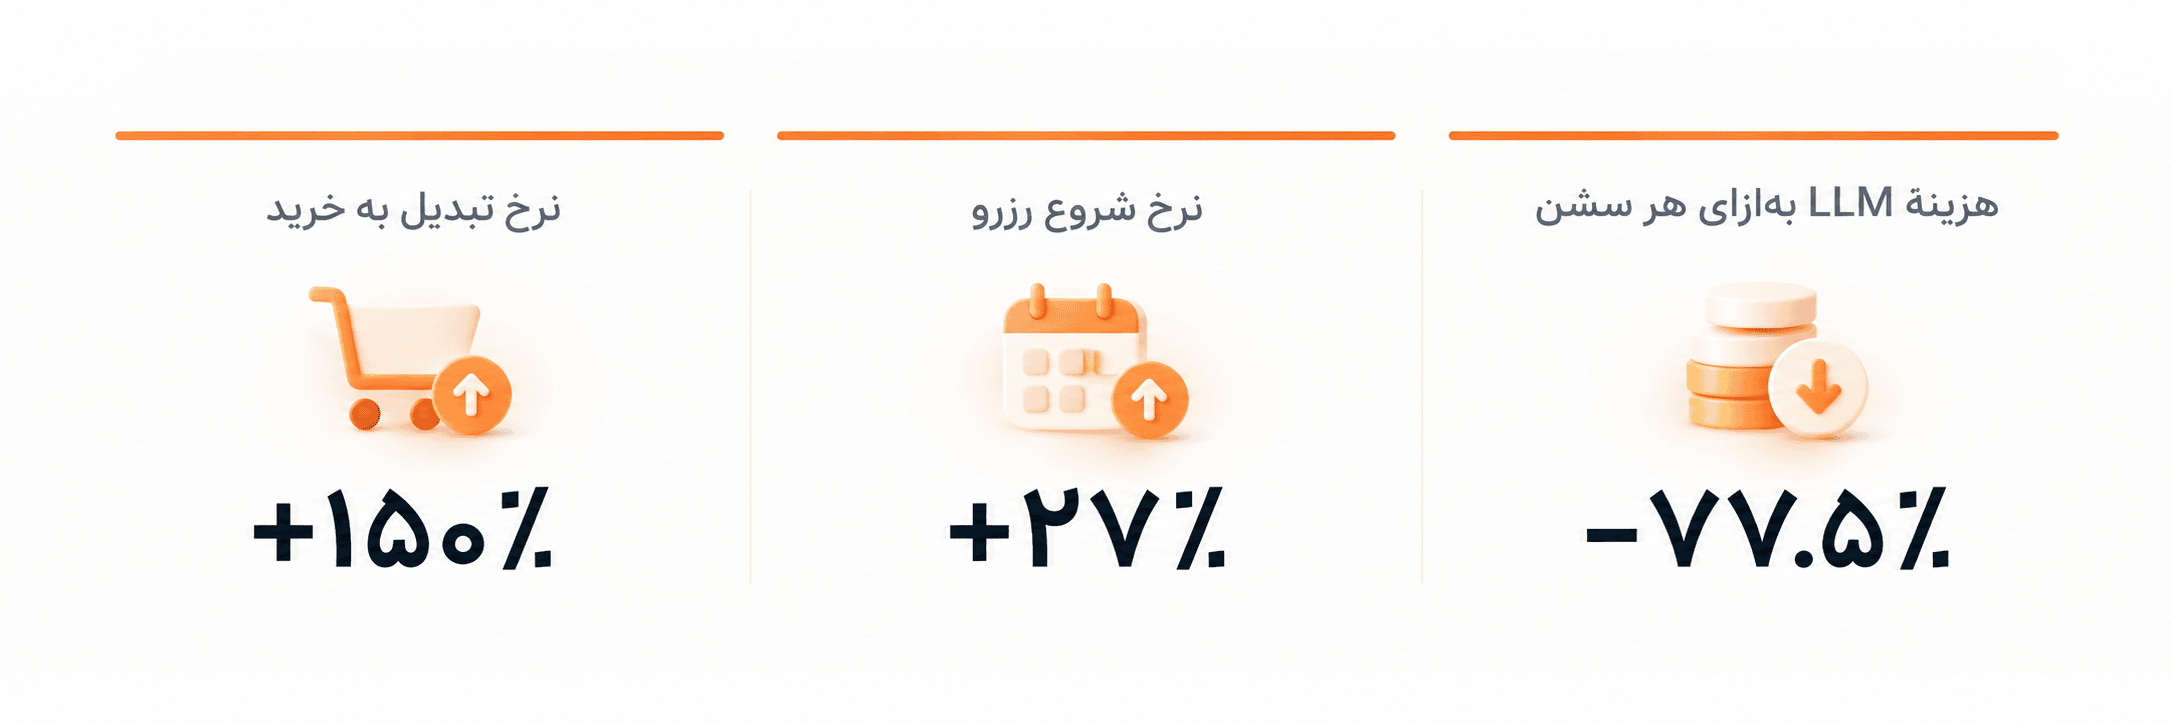
و حرف آخر اینکه، LLMها بهسرعت تغییر میکنند و همراه آنها، محصولاتی که میتوانیم بسازیم هم تغییر میکنند. اما بعضی از این درسها آنقدر عمومیاند که در ادامه هم میتوانیم از آنها استفاده کنیم.