

برای یک سفر چهارنفره، در تاریخی مشخص، دنبال ویلای استخردار هستید. شهر اقامتگاههای زیادی دارد؛ اما چند مورد از میان آنها پیدا میشود که هم استخر دارند، هم ظرفیت مناسب و هم در تمام شبهای سفر قابلرزرو هستند؟ از نگاه مسافر، سؤال همین است: برای این سفر، چه انتخابهایی دارم؟
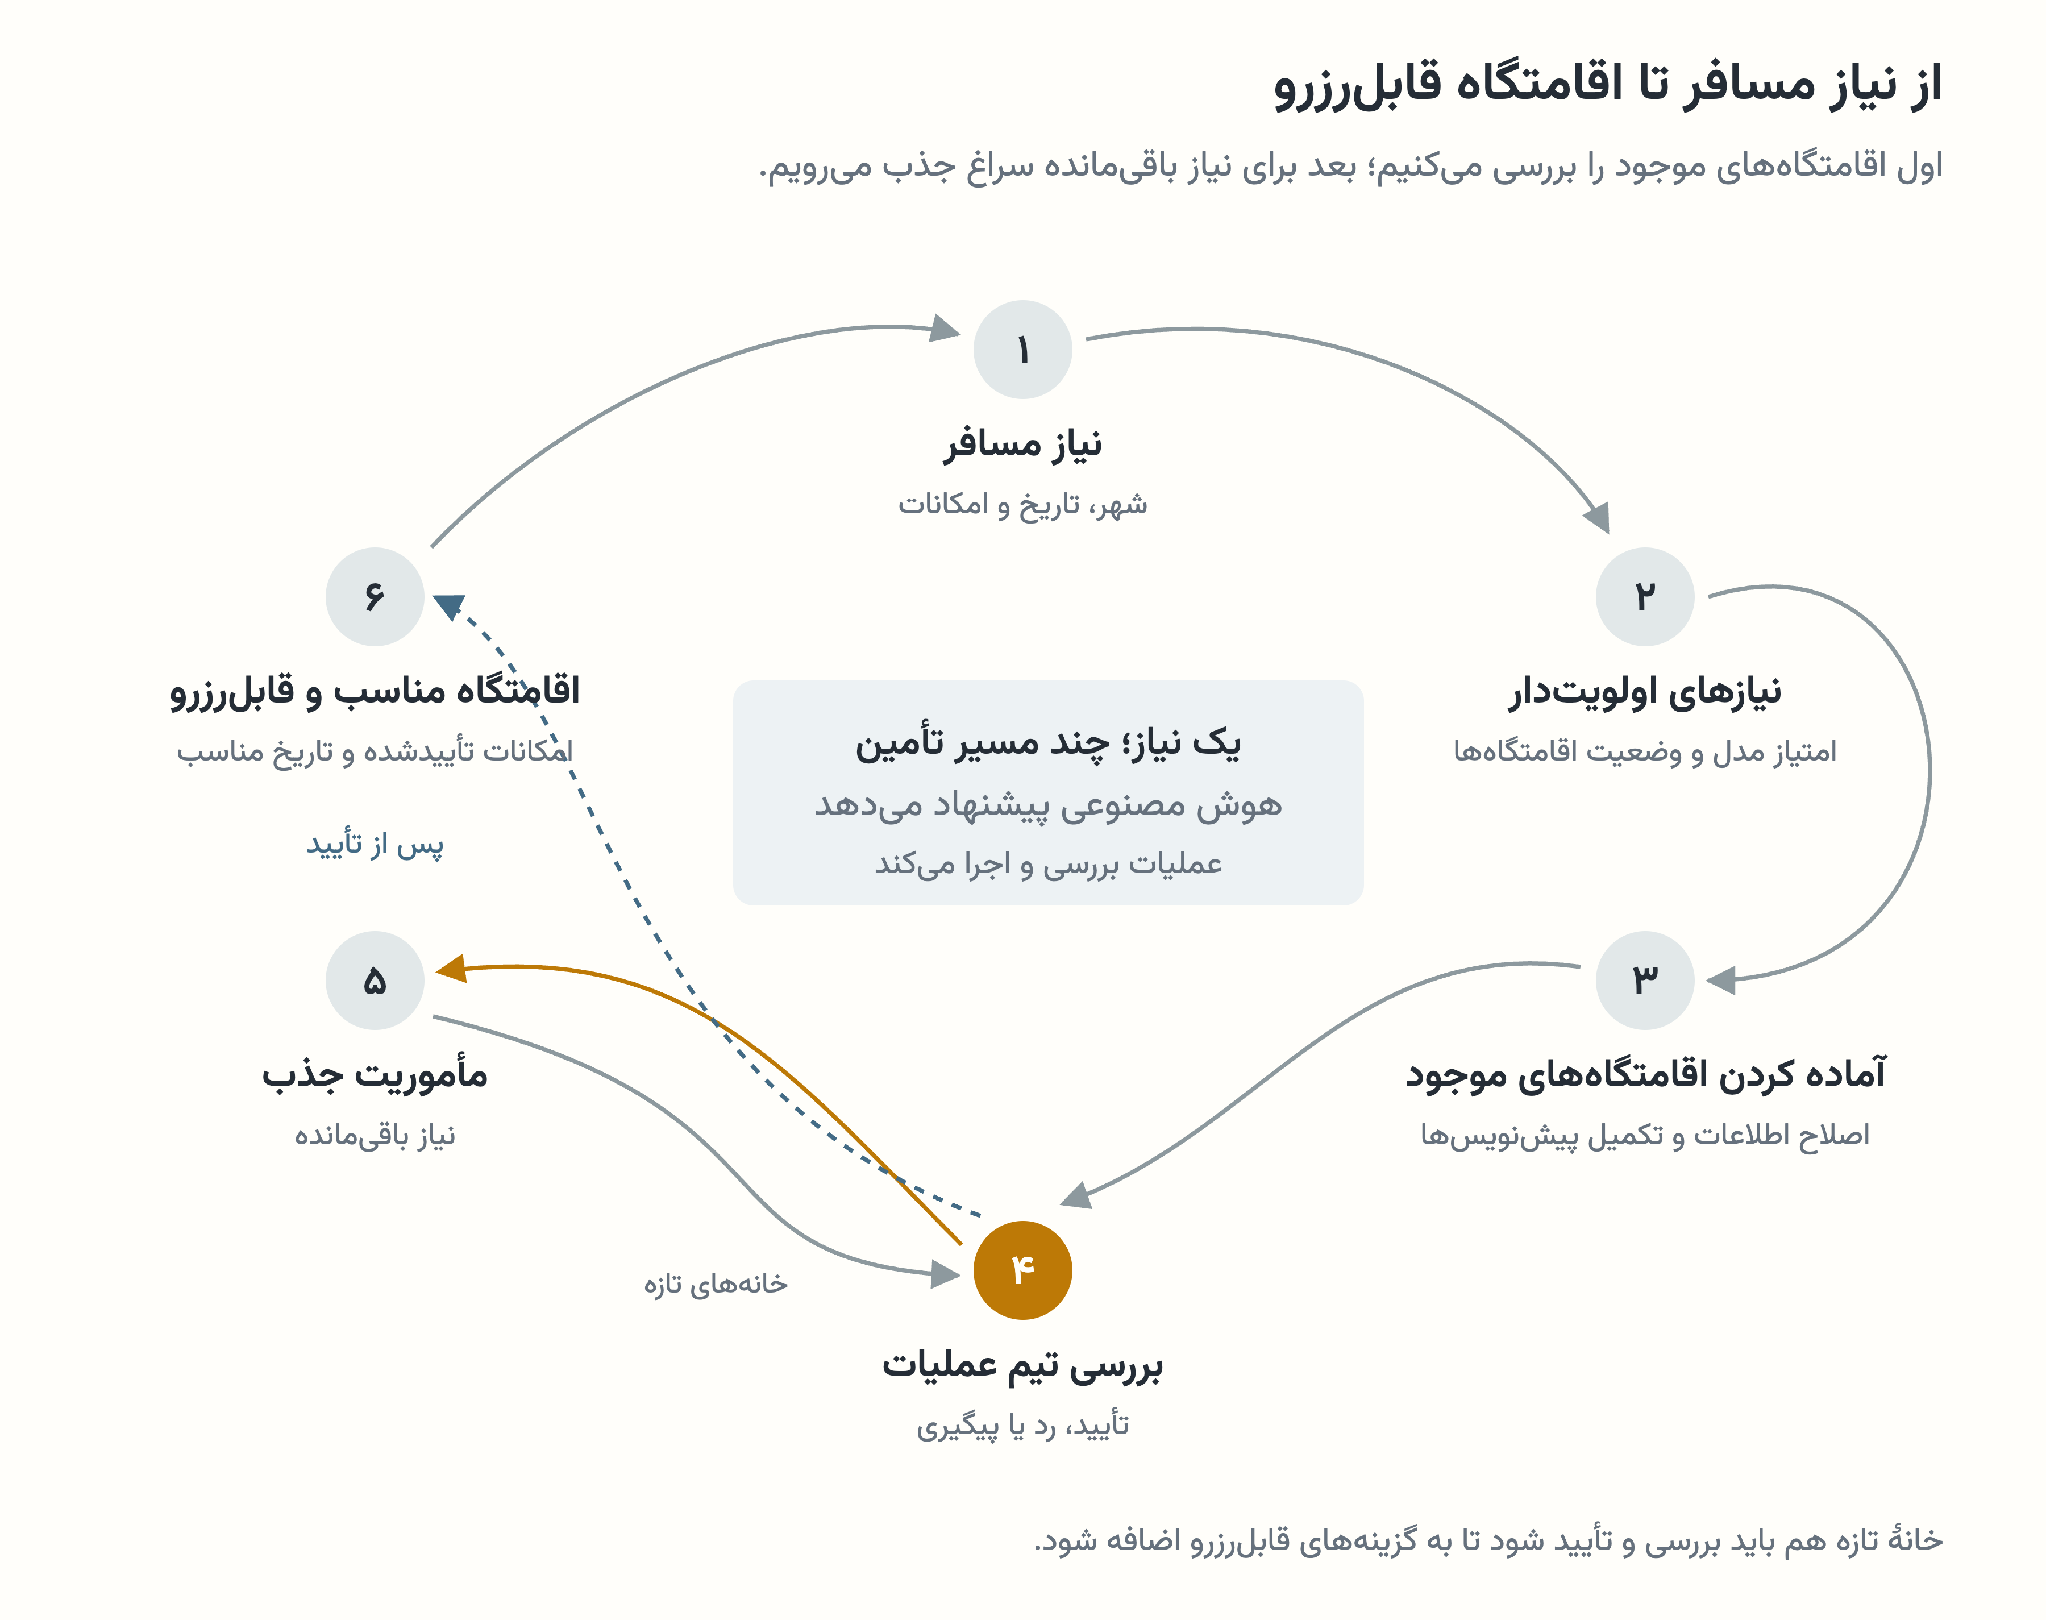
در جاباما، نقدشوندگی را از همین زاویه بررسی میکنیم: مسافر برای سفر موردنظرش چقدر به اقامتگاههای مناسب و قابلرزرو دسترسی دارد؟ LIS، کوتاهشدهٔ Low Inventory State، کمک میکند ببینیم کمبود انتخاب را در کدام جستوجوها بررسی کنیم. سپس این بررسی را به کار مشخص برای عملیات تبدیل میکنیم: اصلاح اطلاعات اقامتگاههای موجود، تکمیل پیشنویسها و جذب خانههای موردنیاز.
نام شهرها و همهٔ عددها ساختگیاند و از دادههای واقعی جاباما به دست نیامدهاند. نمودارها روش را توضیح میدهند و گزارش عملکرد پلتفرم نیستند.
تعداد اقامتگاههای شهر، همهٔ ماجرا را نمیگوید
در همان شهر، انتخاب «ویلا» فقط ویلاها را نگه میدارد و اضافه کردن «استخر»، انتخابها را محدودتر میکند. ممکن است آپارتمانهای خالی زیادی داشته باشیم، اما برای خانوادهای که ویلای استخردار میخواهد، گزینههای کمی باقی مانده باشد. اضافه شدن آپارتمانهای بیشتر، لزوماً مشکل این خانواده را حل نمیکند.
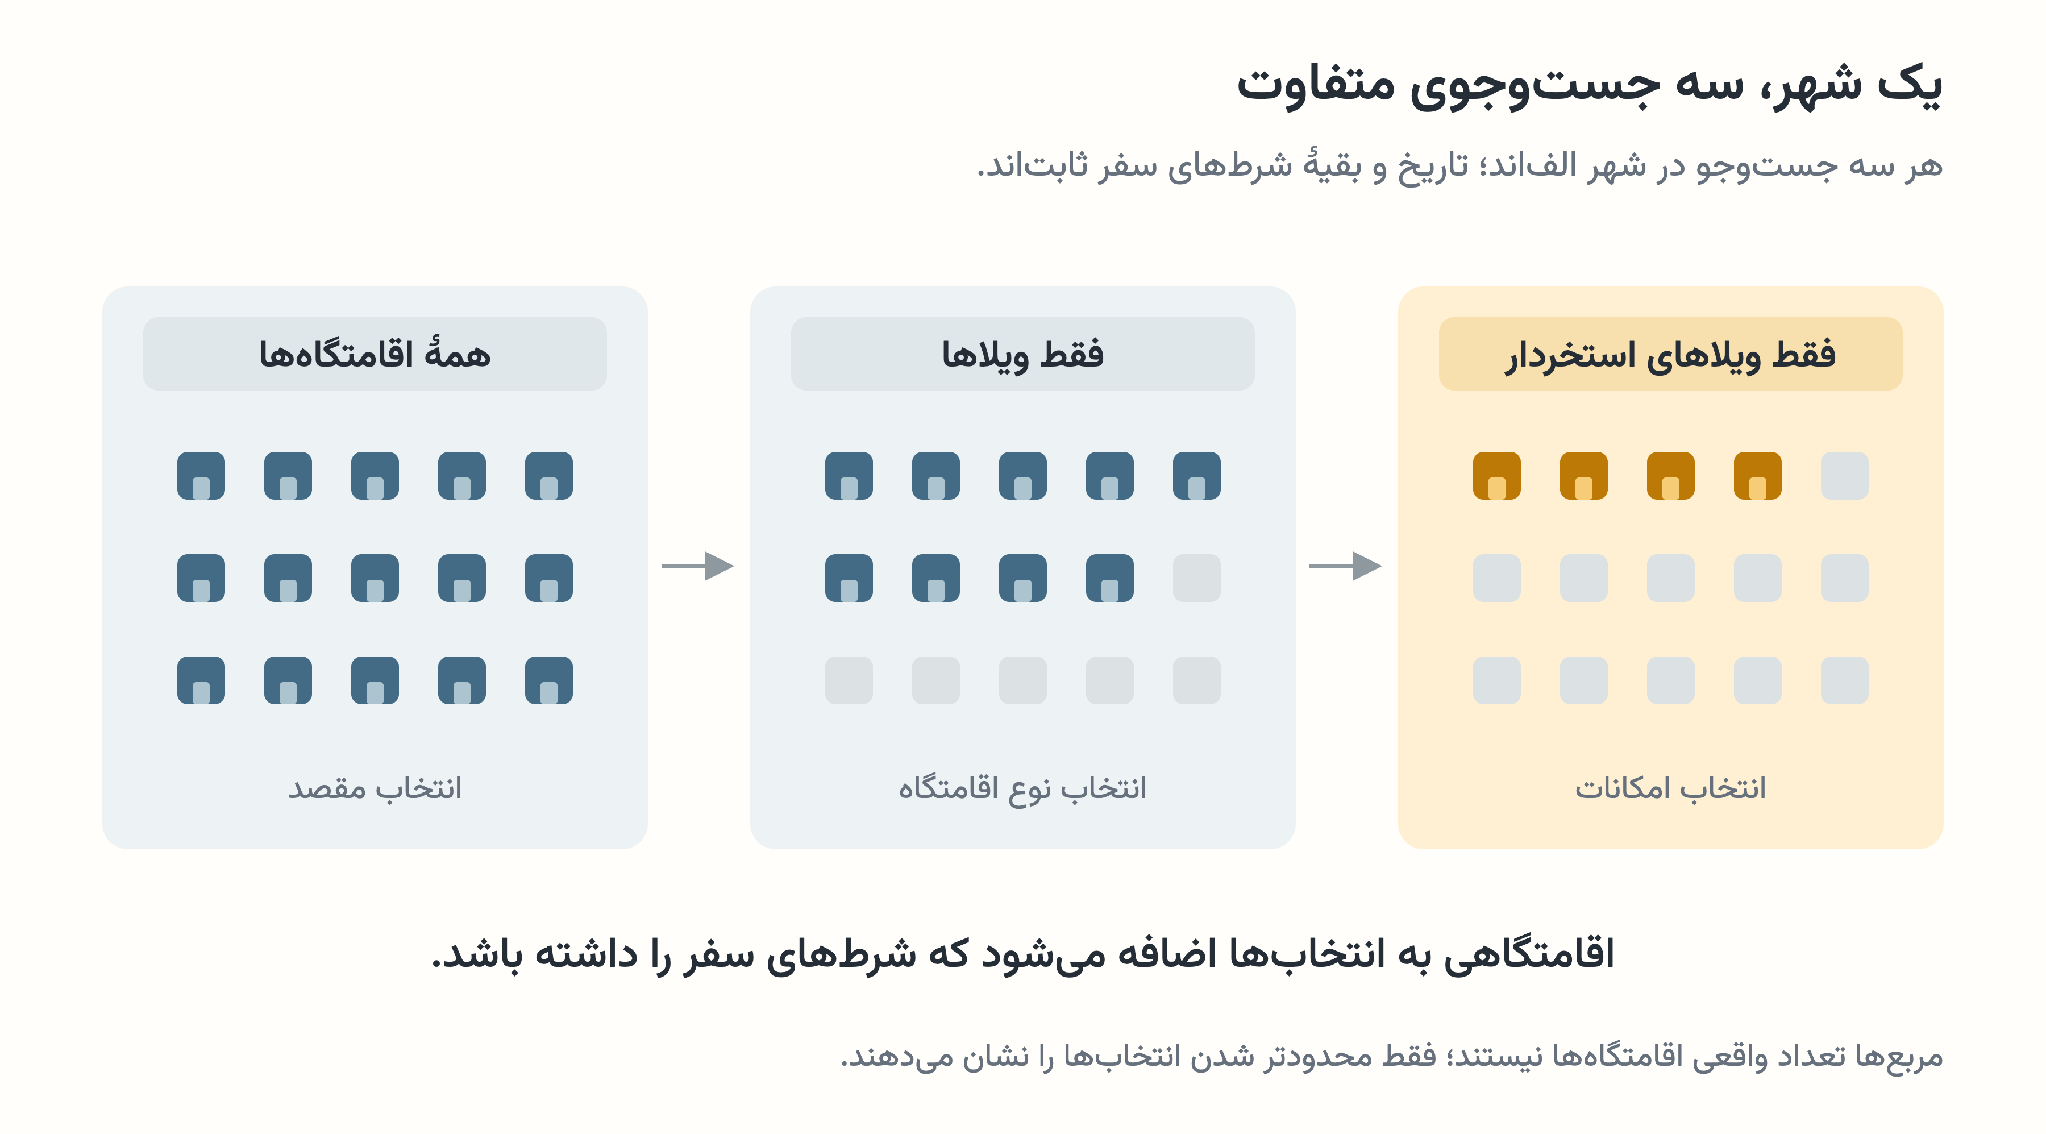
پس کمبود را برای نیازی مشخص، در مکانی مشخص و در تاریخ سفر بررسی میکنیم. ویلایی که هفتهٔ بعد خالی است، پاسخ جستوجوی این آخر هفته نیست.
کدام نیازها را دقیقتر بررسی کنیم
در نمودار حبابی، هر حباب یک گروه مشخص را نشان میدهد: مثلاً کل شهر، ویلاهای آن شهر یا ویلاهای استخردار.
محور افقی، تقاضای بیپاسخ است: سهم جستوجوهایی که در دادههای ما به رزرو نرسیدهاند؛ یعنی سفارش تأییدشدهٔ مرتبطی برایشان ثبت نشده است. هرچه به راست برویم، این سهم بیشتر است.
محور عمودی، اشغال است: از ظرفیت اقامتگاههای مناسب همان جستوجو و تاریخ سفر، چه سهمی رزرو شده است؟ اینجا ظرفیت را بر حسب شب اقامت میسنجیم. هرچه بالاتر برویم، سهم بیشتری از این ظرفیت رزرو شده است.
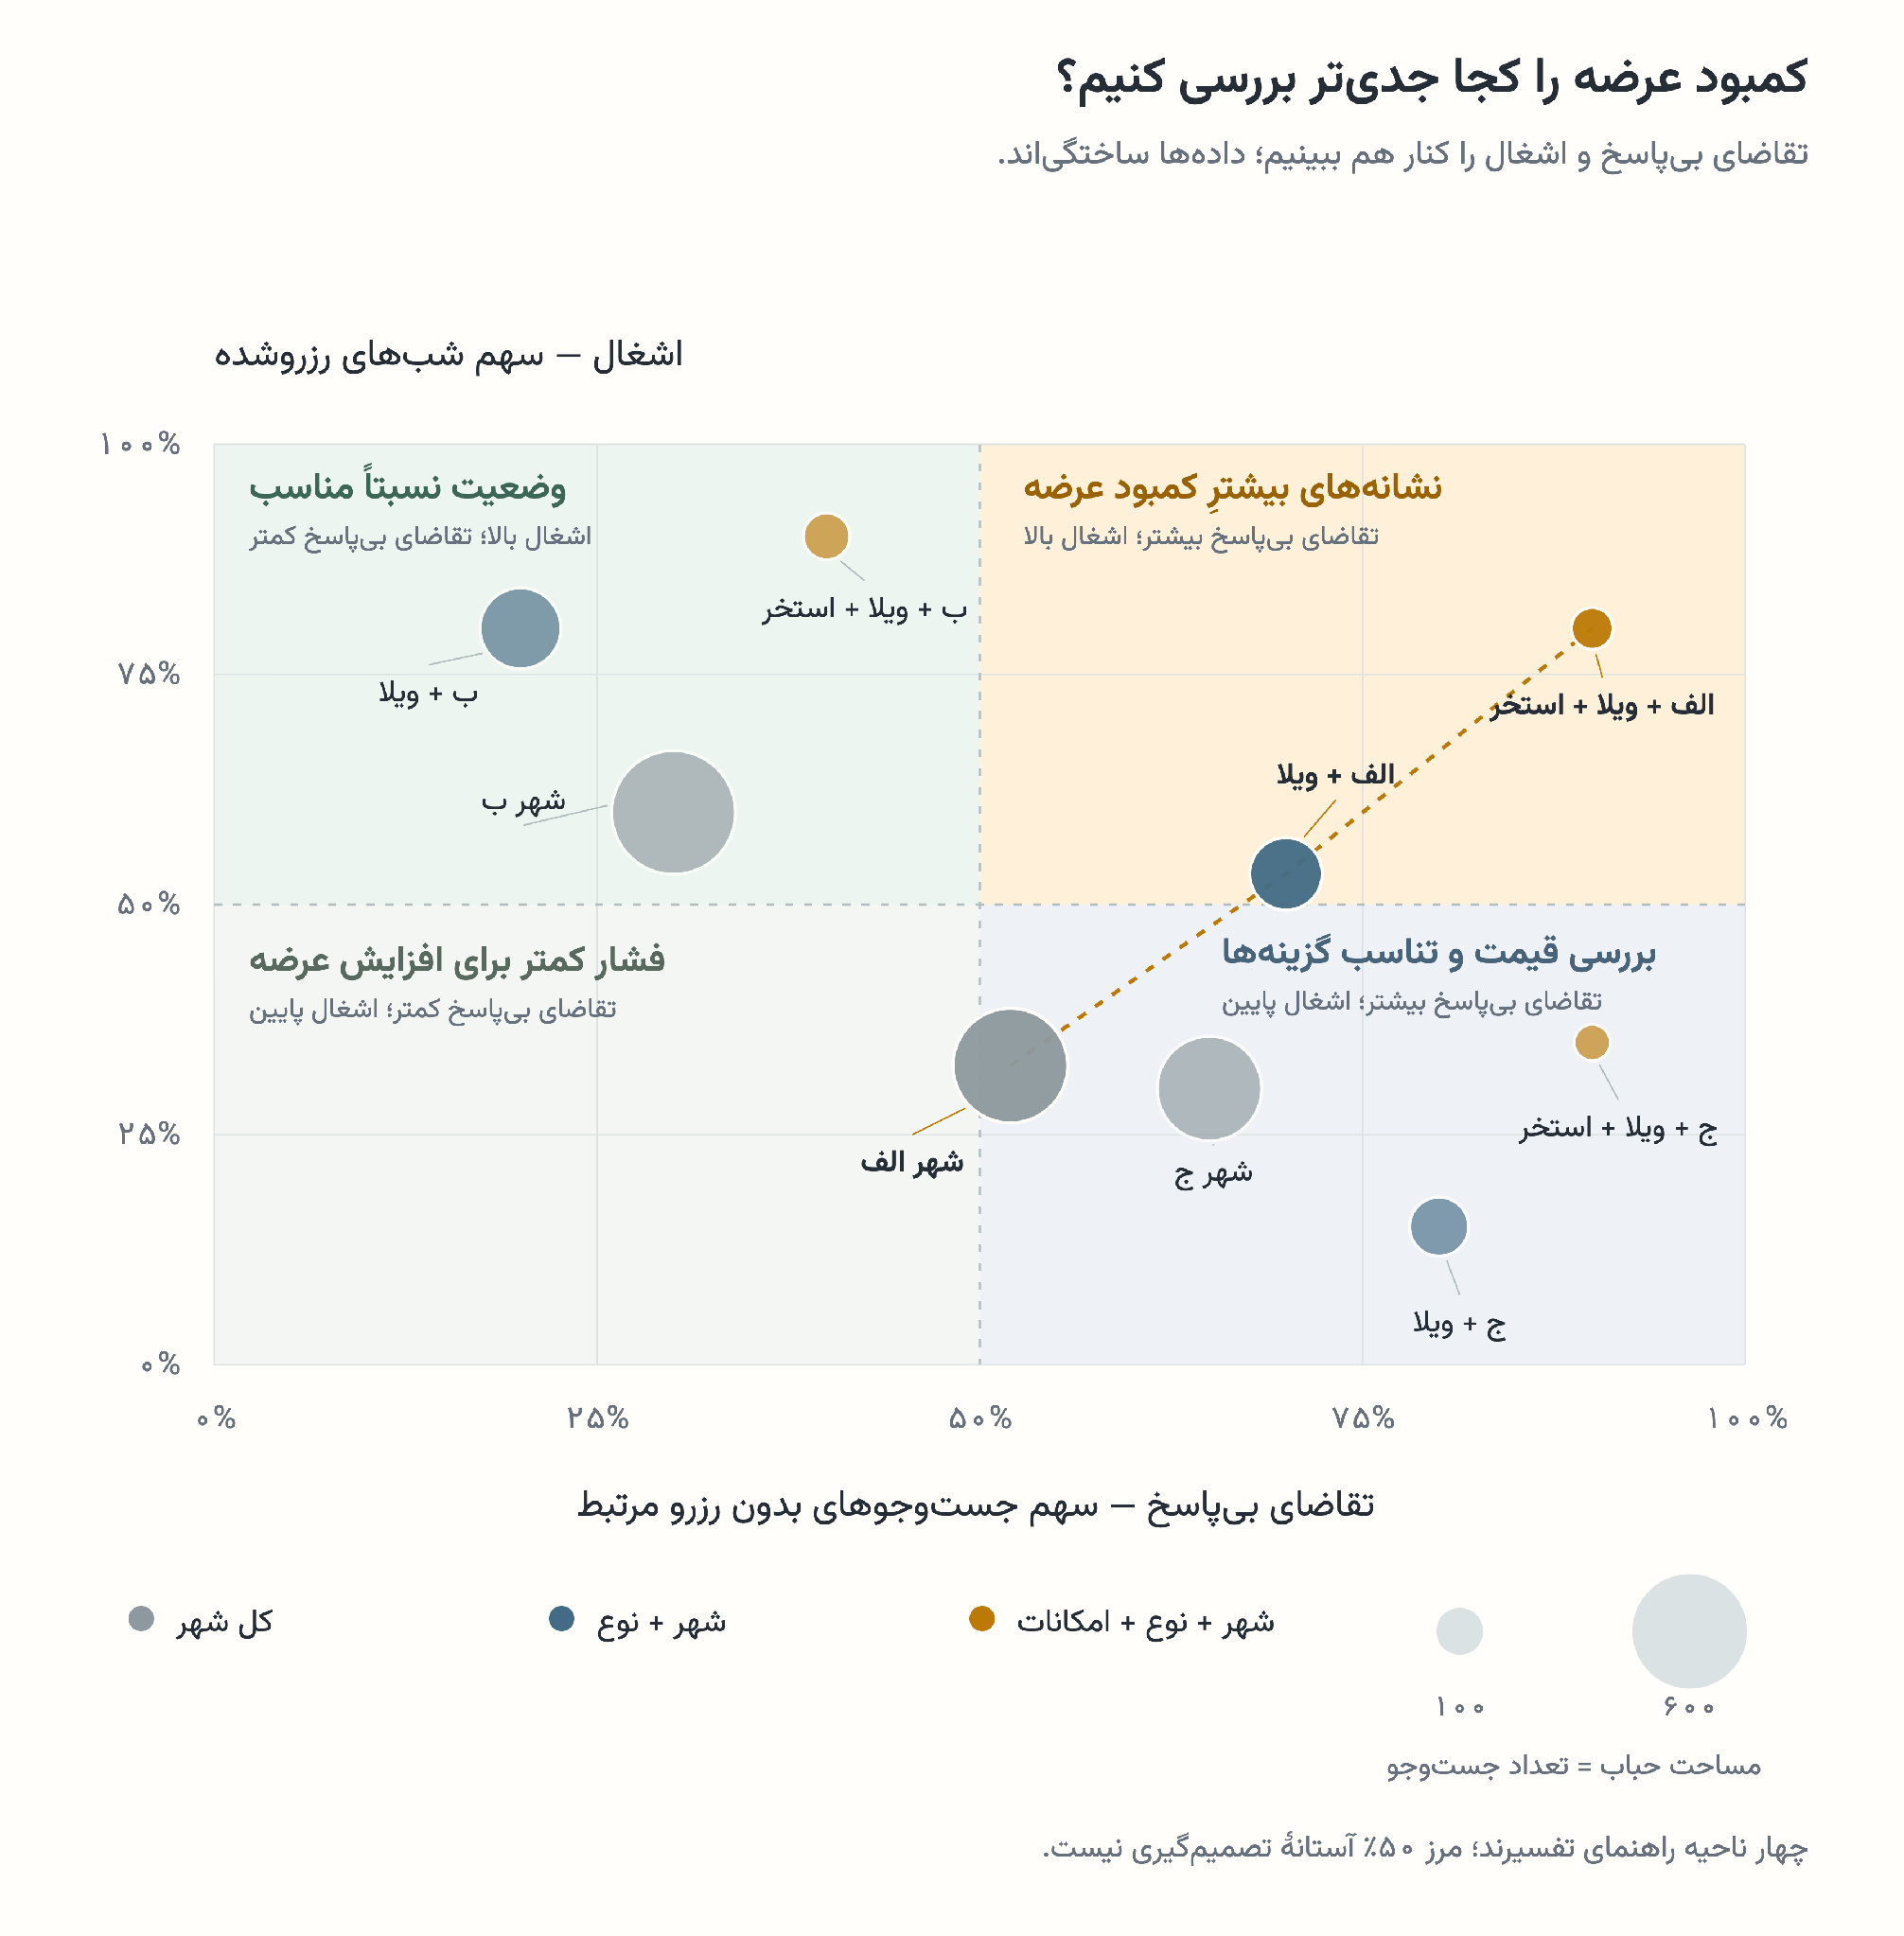
بالا راست، سهم تقاضای بیپاسخ و اشغال هر دو بالاست؛ کمبود عرضه را اینجا جدیتر بررسی میکنیم. پایین چپ، نشانههای کمتری برای افزایش عرضه داریم. بالا چپ، اشغال بالا با تقاضای بیپاسخ کمتر همراه است و وضعیت نسبتاً مناسبتر به نظر میرسد. پایین راست، اشغال پایین است و سهم بیشتری از جستوجوها رزرو مرتبط ندارند؛ پس باید علتهایی مثل قیمت و تناسب گزینهها را هم بررسی کنیم.
خطچین شهر الف را دنبال کنید: از کل شهر به ویلاهای استخردار که میرسیم، حباب کوچکتر میشود، اما به ناحیهٔ کمبود نزدیکتر میرود. میانگین شهر میتواند این تفاوت را پنهان کند. خطچین تغییر زمان نیست و چون گروهها همپوشانی دارند، تعداد جستوجوهای حبابها را نباید با هم جمع زد.
این نمودار سرنخ میدهد. نبود رزرو مرتبط، بهتنهایی علت را مشخص نمیکند و ممکن است بخشی از آن به ناقص بودن ارتباط دادههای جستوجو و سفارش برگردد.
چرا تعداد نتایج بهتنهایی کافی نیست
پنج نتیجه برای یک درخواست بسیار خاص، با پنج نتیجه در یک جستوجوی کلی یکسان نیست. رفتار مسافر هم مهم است: کسی که به رزرو نزدیکتر شده، ممکن است فیلترهای دقیقتری انتخاب کند. نتایجش کمتر میشود، اما تصمیمش برای رزرو جدیتر است.
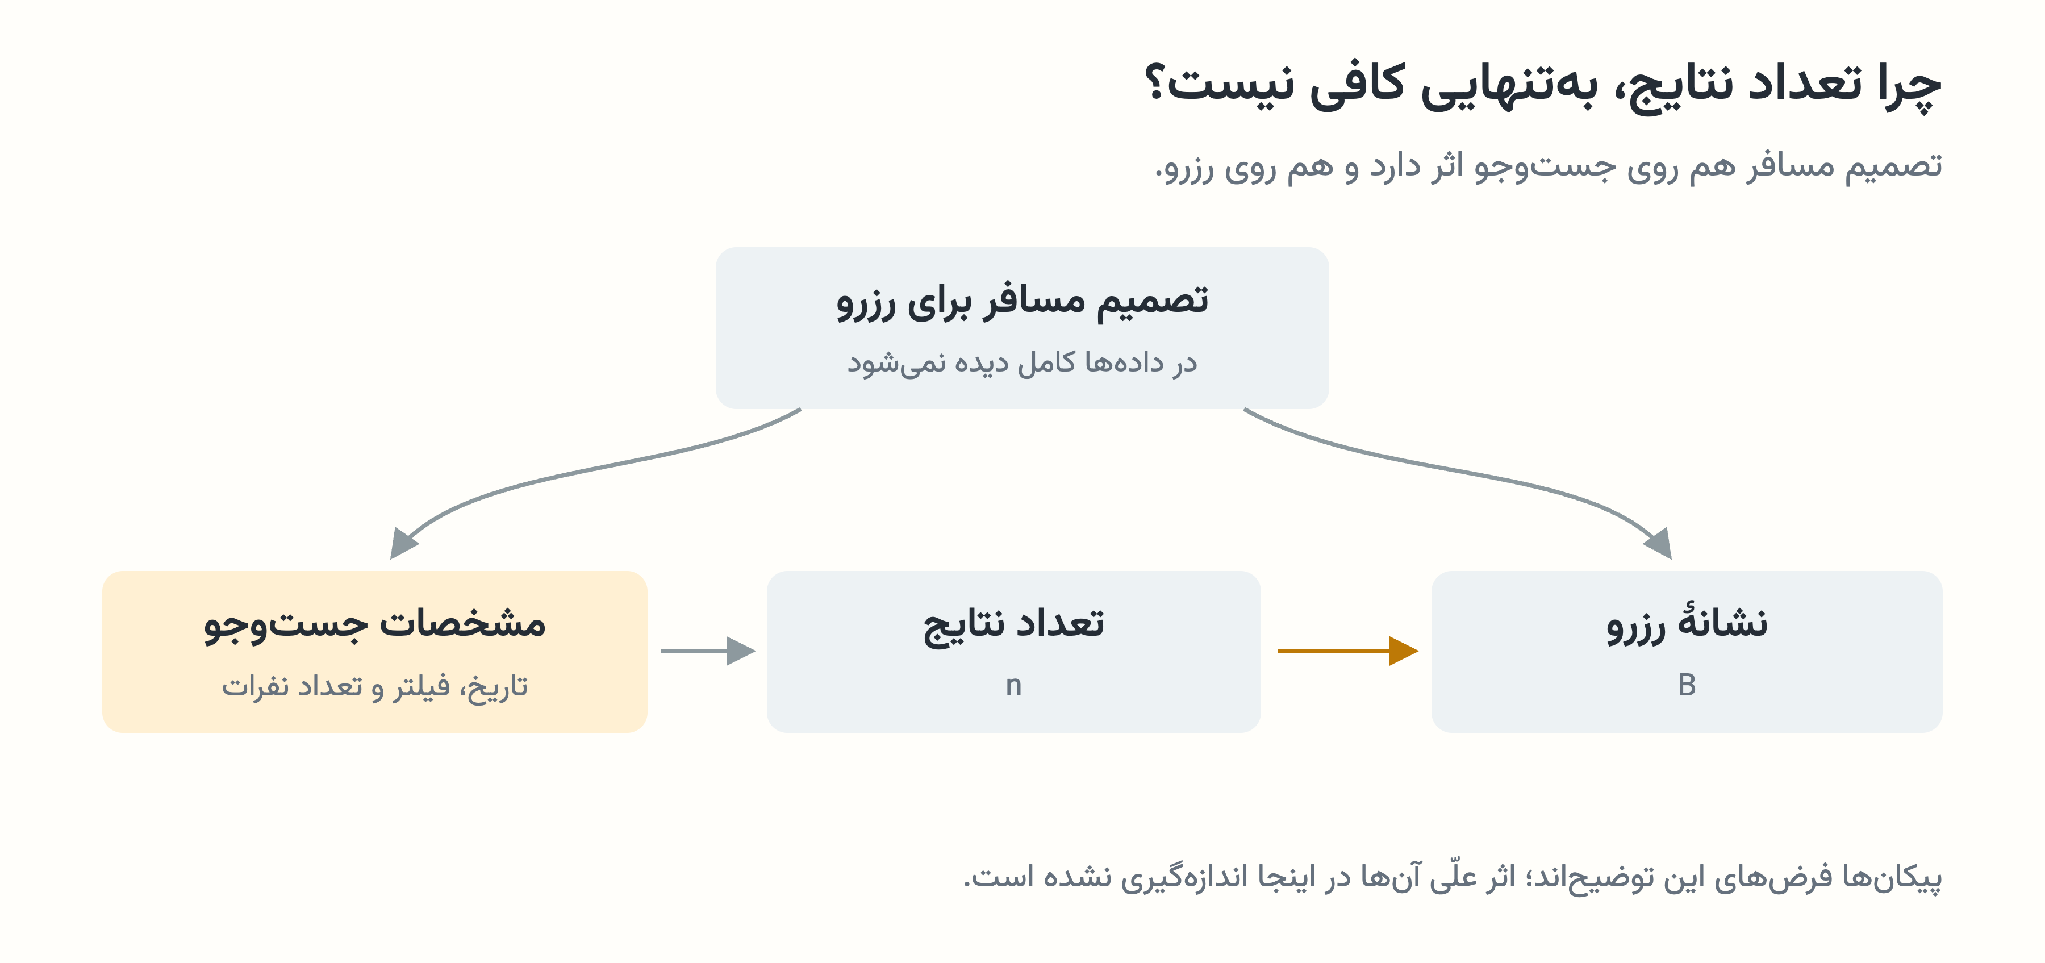
بنابراین رابطهٔ سادهٔ تعداد نتایج و رزرو، اثر اضافه کردن عرضه را مشخص نمیکند. برای پیدا کردن کمبود، باید مشخصات سفر را هم در نظر بگیریم.
پژوهش LIS چه چیزی را مقایسه میکند
با الهام از پژوهش LIS در ایربیانبی [۱]، دو مدل تعداد نتایج را از مشخصات جستوجو پیشبینی میکنند: مدل اول با نمونهای از مجموعهٔ جستوجوها آموزش میبیند و مدل دوم با جستوجوهایی که سفارش مرتبط دارند. این ارتباط در دادههای مدل، «نشانهٔ رزرو» است و لزوماً به معنی تأیید سفارش نیست.
مشخصات یک جستوجو را به هر دو مدل میدهیم. اگر مدل دوم نتایج بیشتری پیشبینی کند، تفاوت دو خروجی سرنخی برای بررسی کمبود انتخاب است: برای این سفر، الگوی تعداد نتایج در جستوجوهای دارای نشانهٔ رزرو با الگوی عمومی فرق دارد.
پیشبینی مدل دوم را بر پیشبینی مدل اول تقسیم میکنیم تا امتیاز R به دست آید. امتیاز بالاتر به بررسی بیشتر جهت میدهد، اما تعداد خانههای لازم یا افزایش رزرو پس از جذب را تعیین نمیکند.
سپس جستوجوهای یک نیاز، مثل ویلای استخردار در شهر الف، را کنار هم میگذاریم. یک حد برای امتیاز انتخاب میکنیم؛ به این حد «آستانه» میگوییم. با بالاتر بردن آستانه، کدام گروه همچنان سهم بیشتری از جستوجوهای بالای آستانه دارد؟
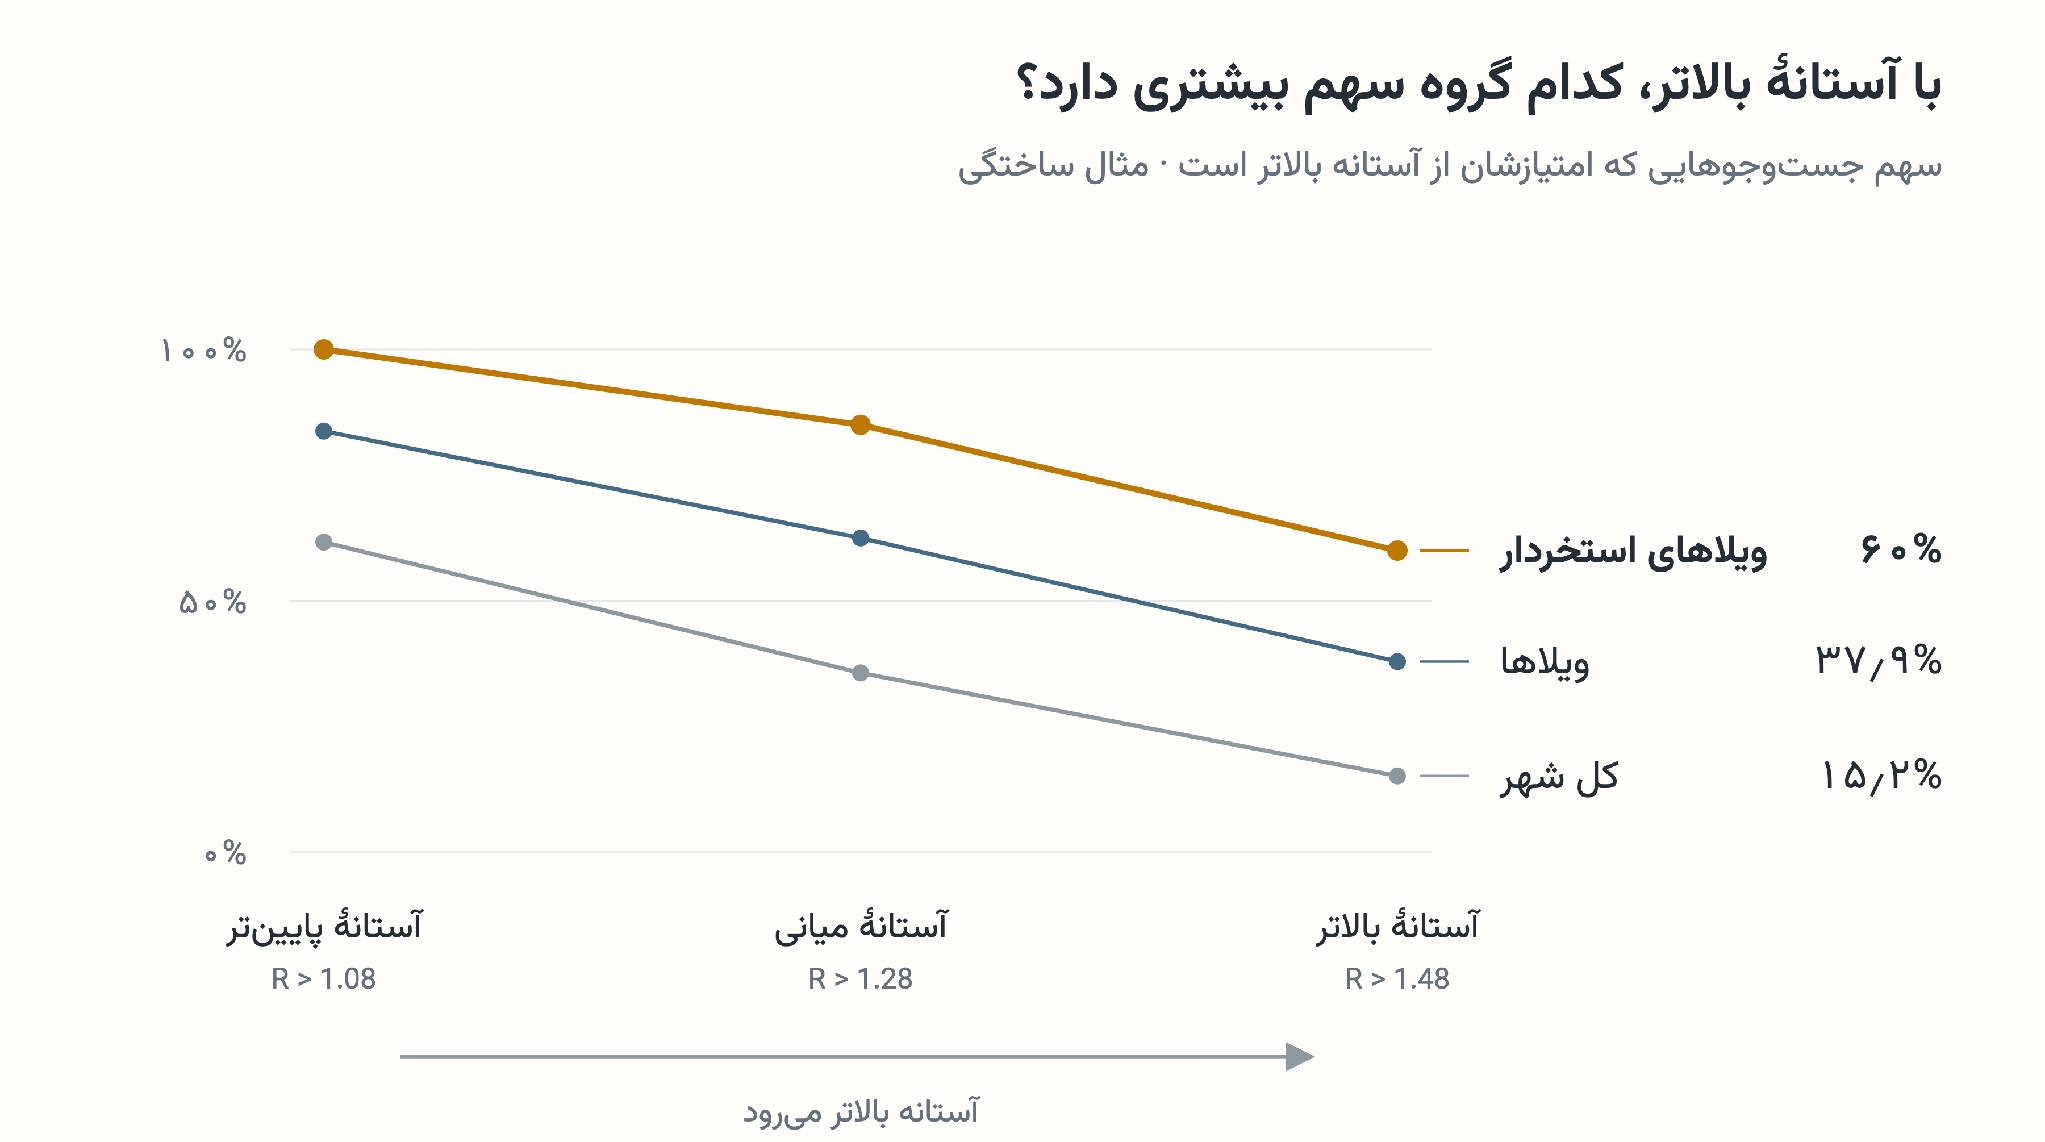
در بالاترین آستانهٔ مثال، این سهم برای ویلای استخردار ۶۰ درصد و برای کل شهر حدود ۱۵ درصد است. تفاوت گروهها در هر سه آستانه دیده میشود. پایین آمدن خطها نتیجهٔ طبیعی افزایش آستانه است؛ این مقایسه، بهتنهایی درستی مدل یا قطعی بودن کمبود را تأیید نمیکند.
از امتیاز مدل تا تصمیم عملیات
دو گروه با تعداد جستوجوی برابر را مقایسه کنید. در «پ»، سهم امتیازهای بالا بیشتر است، اما جستوجوهای دارای نشانهٔ رزرو کمتری داریم. در «ت»، این وضعیت برعکس است.
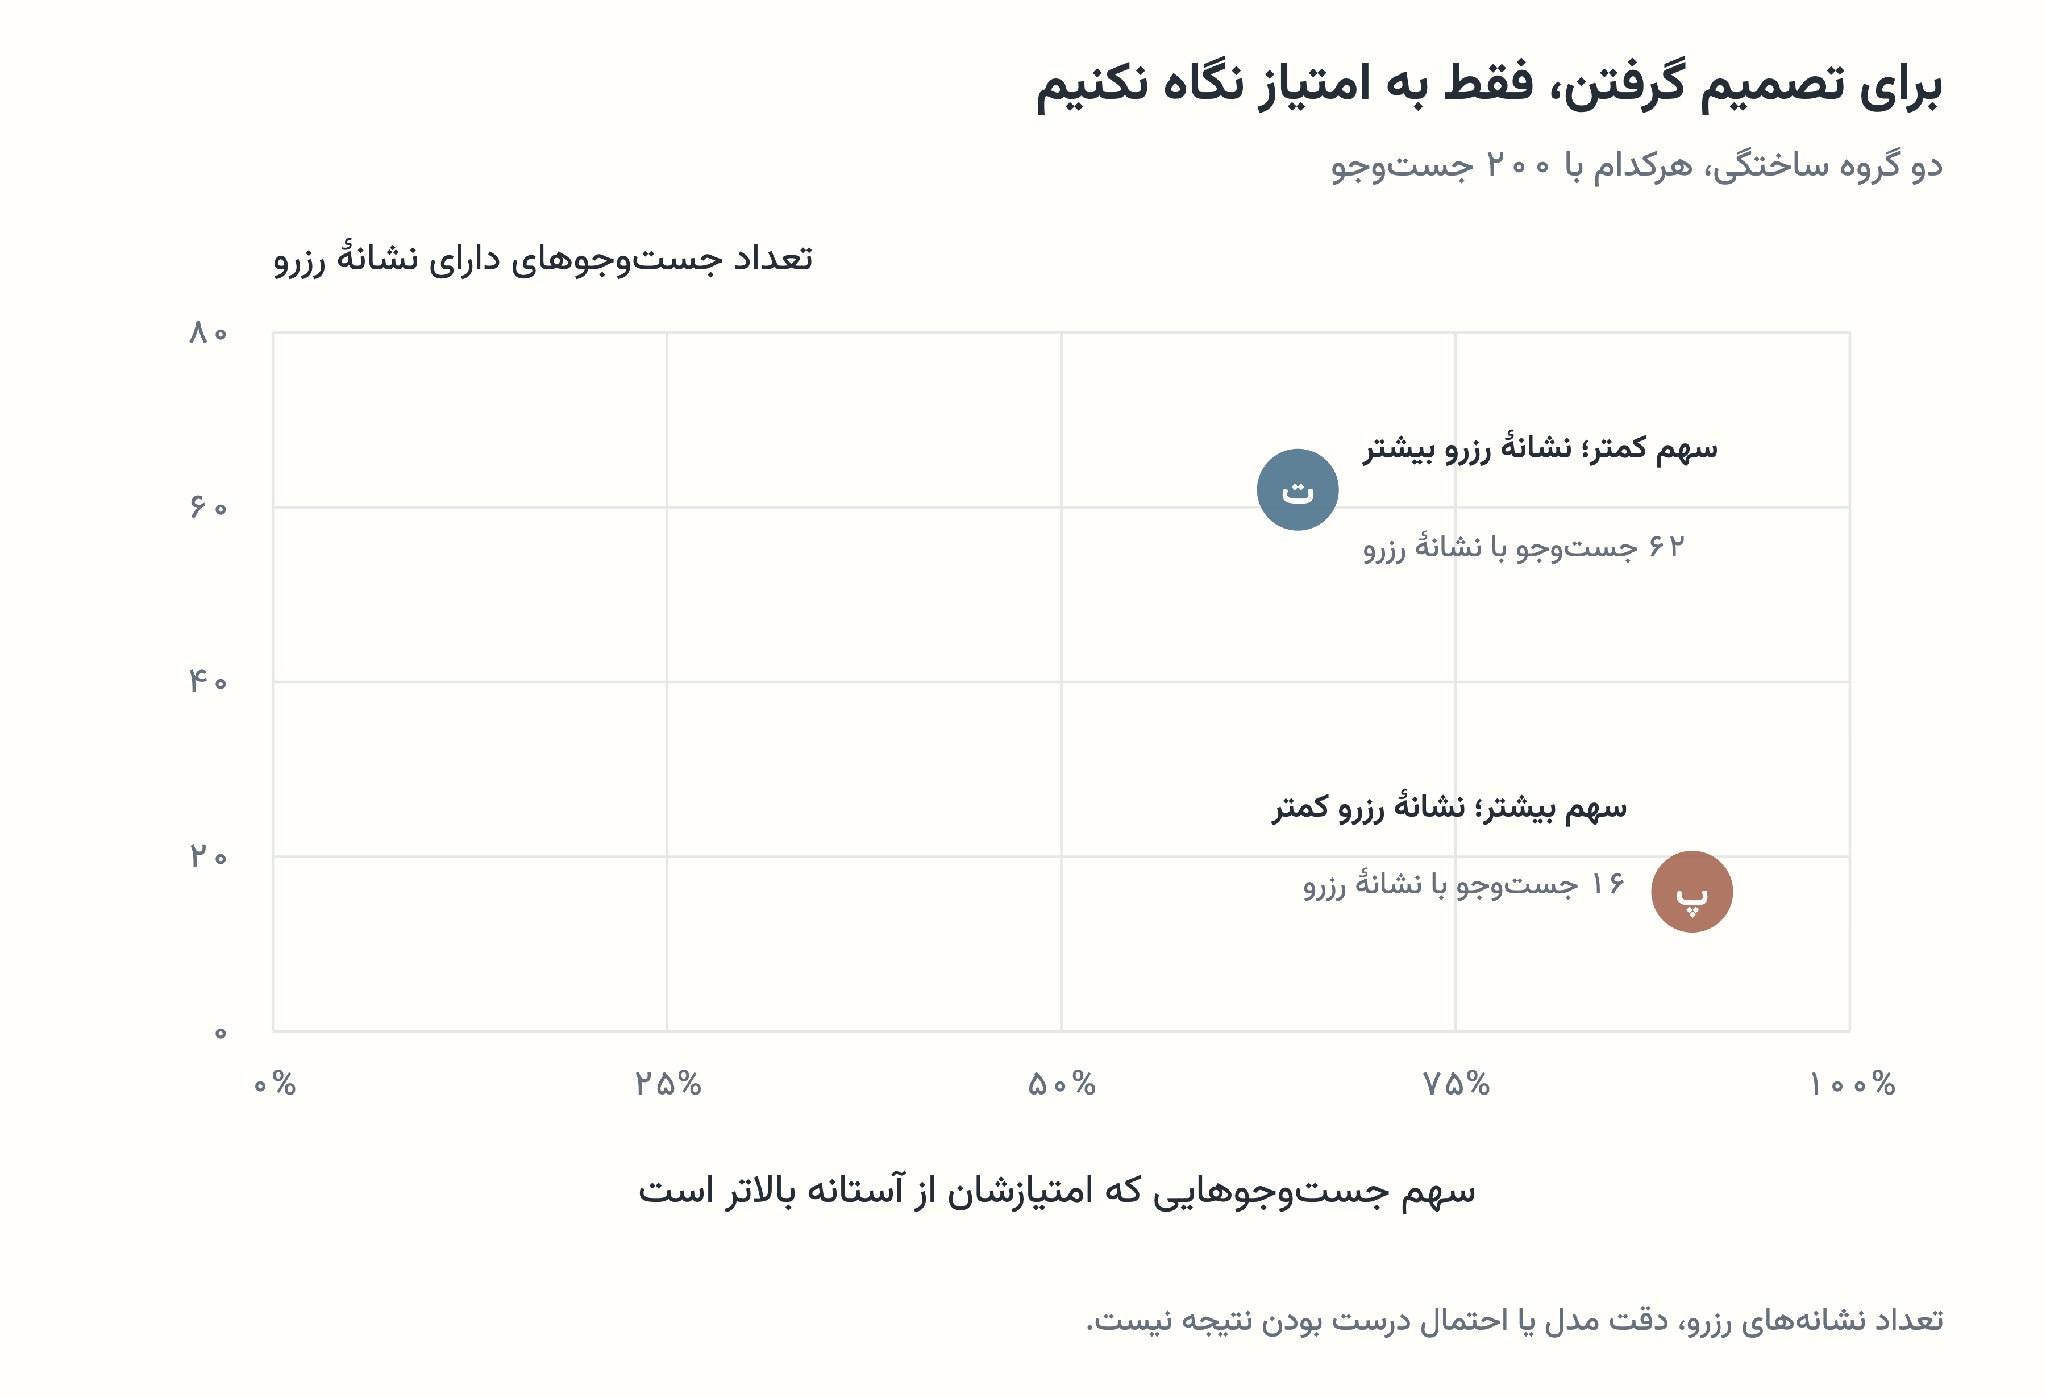
برای اولویتبندی باید کیفیت و کفایت داده، ارتباط جستوجو و رزرو، وضعیت اقامتگاهها و تغییر نتیجه با فرضهای معقول را هم بررسی کنیم. امتیاز بالا، شروع بررسی است؛ اقدام عملیات به نتیجهٔ این بررسی بستگی دارد.
پیش از جذب اقامتگاه تازه، سراغ اقامتگاههای موجود برویم
اگر بررسیها نیاز به انتخابهای بیشتر را نشان داد، اول میپرسیم: چه بخشی از این نیاز را با اقامتگاههای موجود میتوان پاسخ داد؟ شاید اطلاعات یک ویلا ناقص باشد یا خانهای مناسب هنوز در مرحلهٔ پیشنویس مانده باشد. برای نیاز باقیمانده، مأموریت جذب تعریف میکنیم.
امکاناتی که وجود دارند، اما در جستوجو دیده نمیشوند
ویلایی ممکن است استخر داشته باشد، اما این ویژگی در اطلاعاتش ثبت یا فعال نشده باشد. با انتخاب فیلتر استخر، ویلا از نتایج کنار میرود. اصلاح اطلاعات میتواند همین گزینهٔ موجود را به نتایج برگرداند.
برای پیدا کردن این موارد، از موقعیت جغرافیایی برای پیشنهاد تگهای مکانی و از استخراج ویژگی عکسها برای شناسایی امکانات قابلمشاهده کمک میگیریم. هوش مصنوعی موارد محتمل و شواهدشان را پیشنهاد میدهد؛ عملیات آنها را بررسی میکند و در صورت نیاز از میزبان پیگیری میکند.
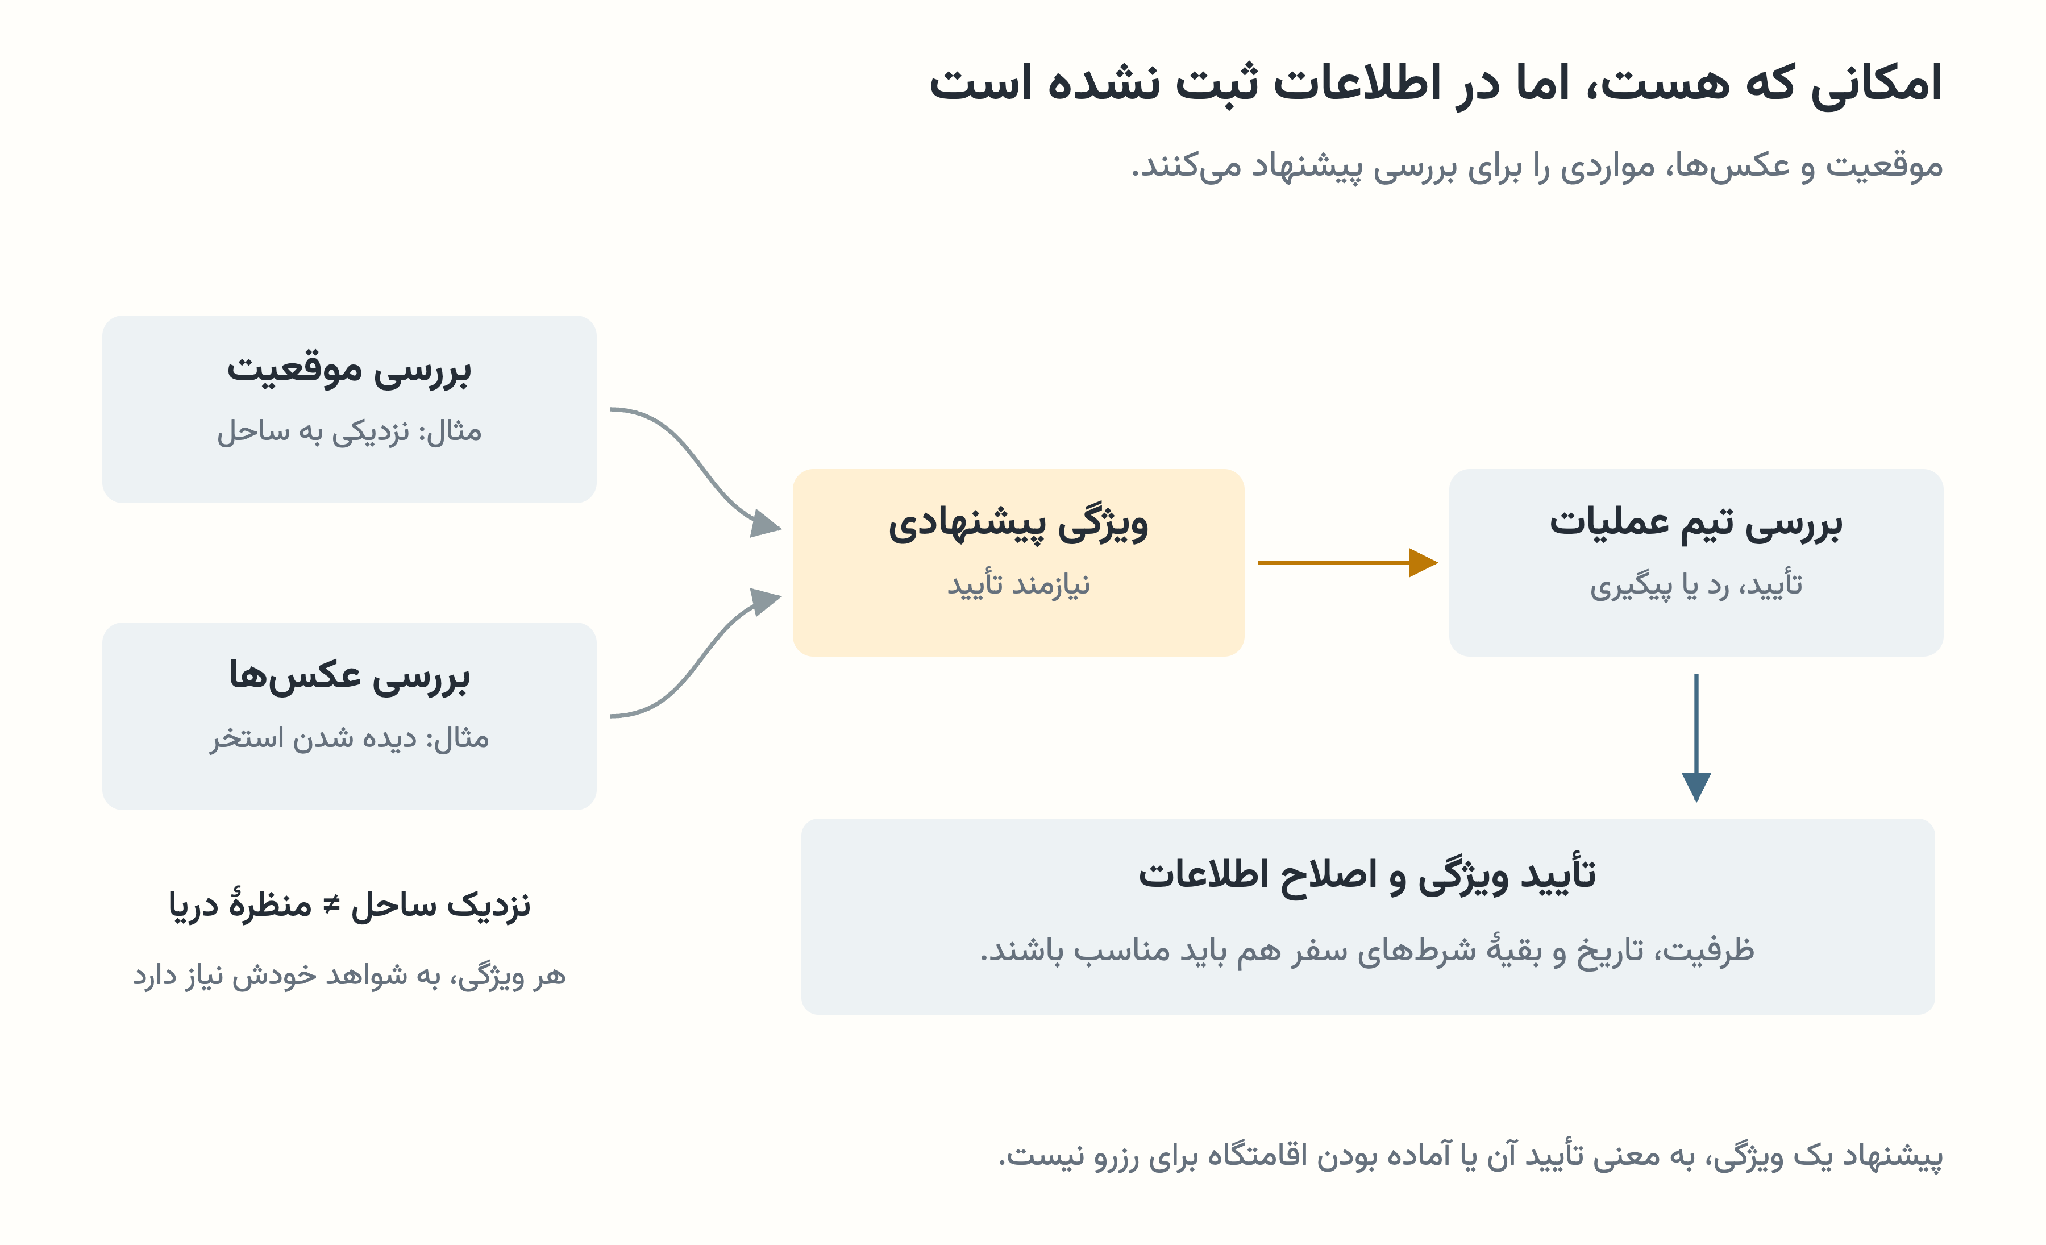
هدف، کامل شدن اطلاعات به شکلی است که اقامتگاه مناسب، در جستوجوی مسافر دیده شود و قابلرزرو باشد.
تکمیل کدام پیشنویس را جلو بیندازیم؟
اطلاعات هر پیشنویس را با نیاز مسافر مقایسه میکنیم: همهٔ شرطهای اصلی را دارد یا فقط بخشی از آنها را؟ امکانات اختیاری و زمان ثبت اقامتگاه هم در اولویتبندی نقش دارند. عملیات از این فهرست برای پیگیری میزبان و آماده کردن اقامتگاه استفاده میکند.
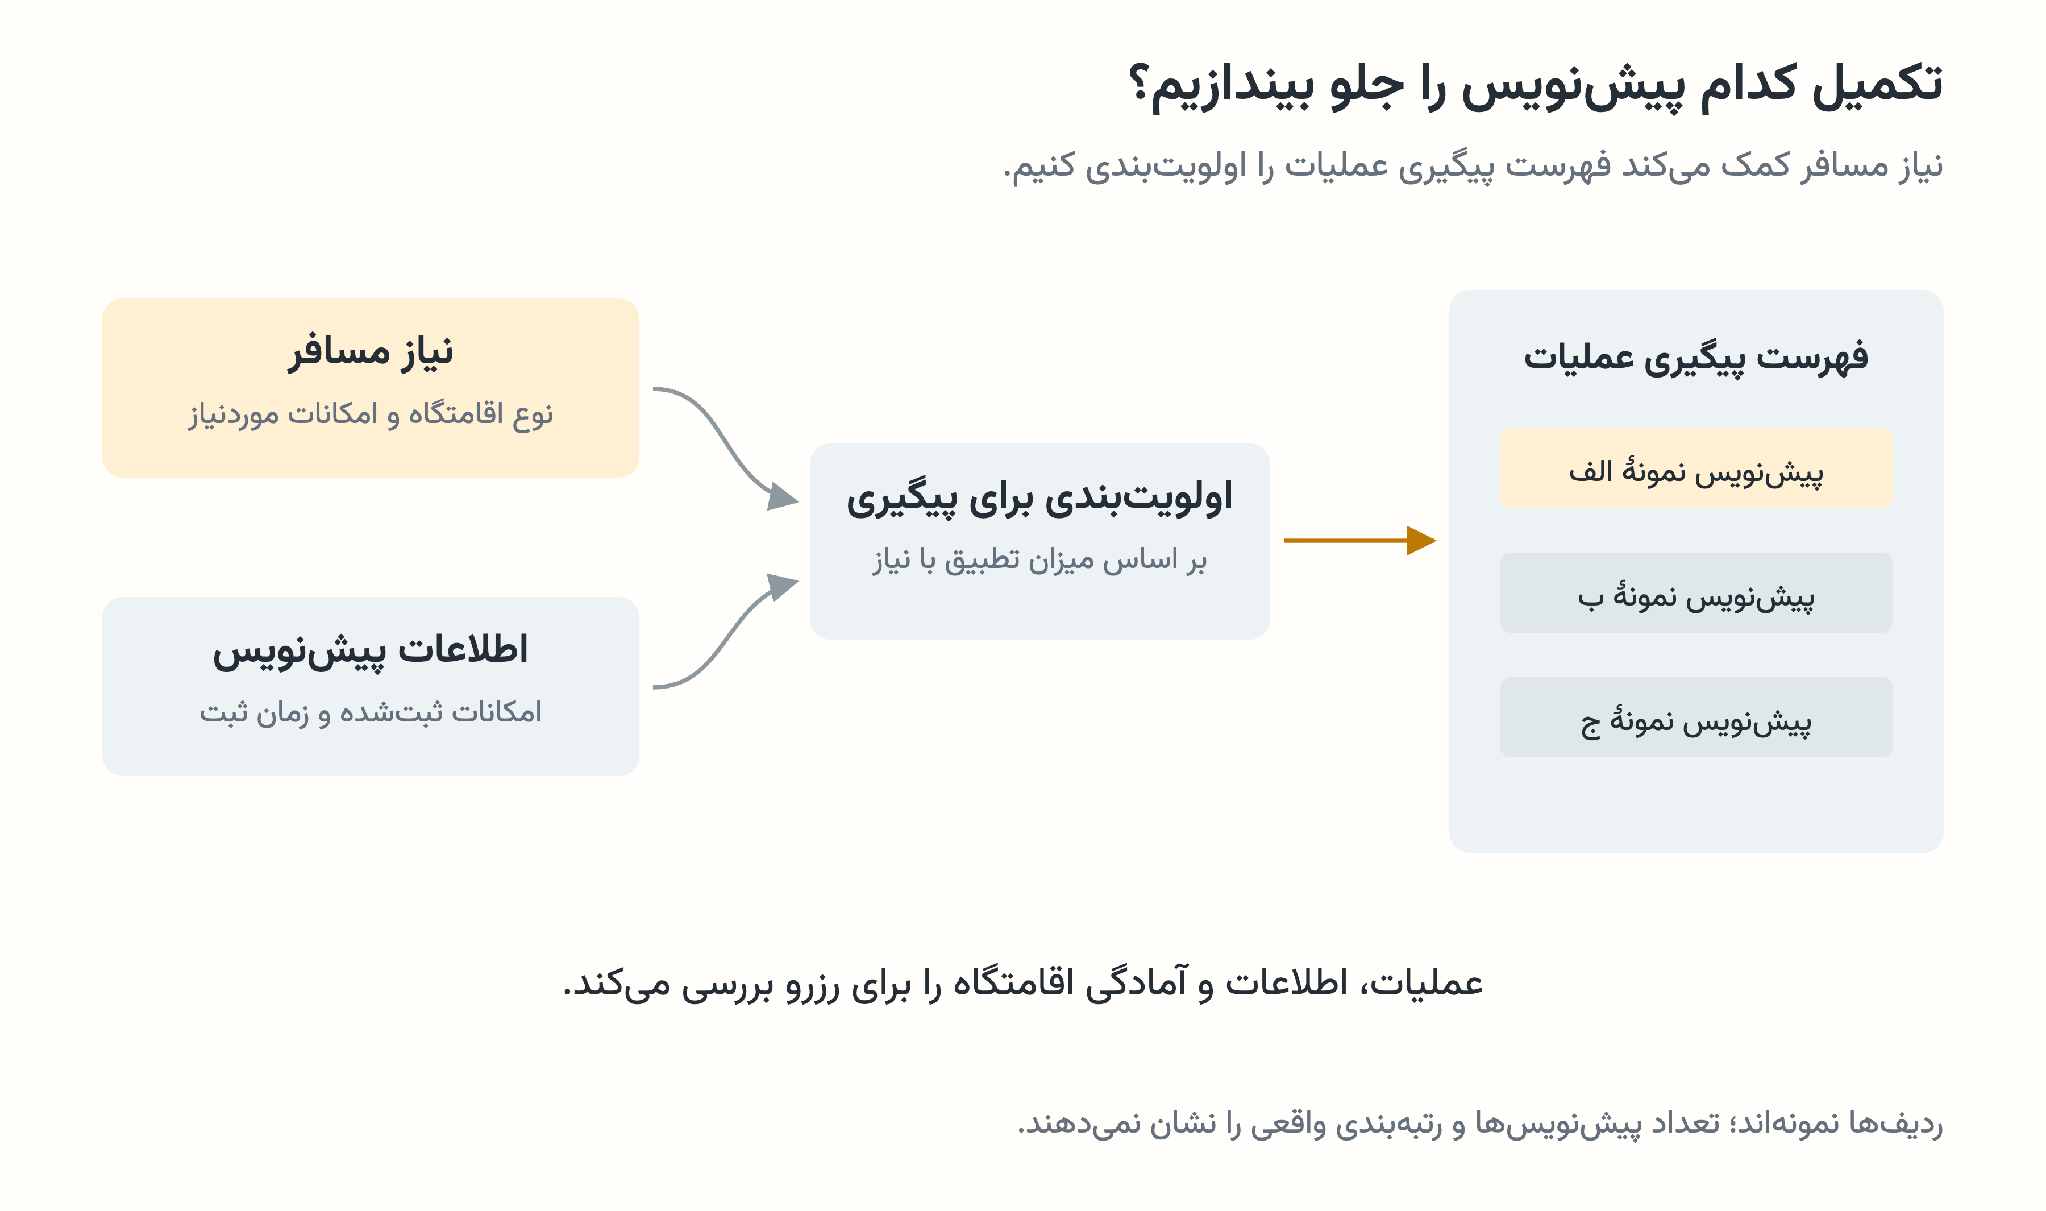
تطبیق جزئی را پاسخ کامل به نیاز حساب نمیکنیم. ثبت نشدن یک امکان هم نبودن آن را ثابت نمیکند و ممکن است به بررسی نیاز داشته باشد.
برای کمبود باقیمانده، مأموریت جذب تعریف کنیم
درخواست جذب باید روشن باشد: در کدام شهر، چه نوع خانهای و با چه امکاناتی میخواهیم؟ عملیات هدف جذب شهر را تعیین میکند. نوع اقامتگاه و امکانات موردنیاز مشخص میکند برای رسیدن به این هدف، سراغ چه خانههایی برویم.
یک خانه میتواند چند نیاز را پوشش دهد؛ پس هدفهای هر ویژگی را جمع نمیزنیم تا تعداد خانههای لازم به دست آید. با پیشنهاد تگ، پیدا شدن پیشنویس یا جذب خانهٔ تازه، کار تمام نشده است. تا امکانات، آمادگی و امکان رزرو تأیید نشود، نمیگوییم انتخاب تازهای برای مسافر فراهم شده است.
نتیجهٔ تأیید، رد و پیگیری ثبت میشود تا اجرای دوبارهٔ تحلیل، کار قبلی را پاک نکند. با دادههای تازه، میبینیم چه نیازی باقی مانده و قدم بعدی چیست. گاهی پاسخ، جذب خانهای تازه است؛ گاهی آماده کردن خانهای که از قبل داریم.
واحد تحلیل و بازهٔ مقایسه
در نمودار حبابی، هر شناسهٔ جستوجو یک بار شمرده میشود؛ تعداد جستوجو، تعداد کاربر یا سفارش نیست. «تقاضای بیپاسخ» سهم جستوجوهایی است که در یک بازهٔ هفتروزهٔ کامل، سفارش تأییدشدهٔ مرتبط ندارند. ناقص بودن این ارتباط میتواند مقدار شاخص را تغییر دهد، پس آن را معادل قطعیِ رزرو نکردن کاربر نمیگیریم.
اشغال، نسبت شبهای رزروشده به مجموع شبهای رزروشده و قابلرزرو در اقامتگاههای مرتبط است. هر اقامتگاه در هر شب یک واحد محسوب میشود. مثال برای دو شب مشترک است و شبهای غیرفعال در مخرج نیستند؛ این تنظیمات فرضیاند.
تقاضا و عرضه باید به تاریخ اقامت یکسان مربوط باشند. جمع کردن جستوجوهای چندین روز و مقایسه با یک تصویر لحظهای از موجودی، میتواند نسبتها را منحرف کند. فصل، روزهای هفته و وضعیت اقامتگاه در همان دوره نیز باید در مقایسه در نظر گرفته شوند. اشغال بهتنهایی معیار نقدشوندگی نیست؛ عرضهٔ قابلرزرو در برابر تقاضا و امکان رزرو کل مدت سفر هم اهمیت دارد.
دو مدل و منطق امتیاز
مشخصات جستوجو را با q و تعداد نتایج را با n نشان میدهیم. مقصد، تاریخ سفر، تعداد نفرات و فیلترها از اطلاعاتی هستند که زمینهٔ جستوجو را توصیف میکنند. دو مدل مبتنی بر درختهای تصمیم، با روش تقویت گرادیانی و تابع زیان پواسون، میانگین تعداد نتایج را پیشبینی میکنند: λ_all(q) برای نمونهٔ عمومی و λ_book(q) برای گروه دارای نشانهٔ رزرو.
استفاده از درختهای تقویتی، امکان مدل کردن رابطههای غیرخطی و ترکیب ویژگیها را فراهم میکند؛ مثلاً یک امکان میتواند در دو مقصد یا فصل، با الگوی متفاوتی همراه باشد. تعداد نتایج، هدف پیشبینی است و نشانهٔ رزرو، نمونههای آموزش مدل دوم را مشخص میکند. هیچکدام ورودی مدل نیستند؛ وارد کردن آنها به ویژگیها، اطلاعات پاسخ را به مدل نشت میدهد.
برای ساخت امتیاز، از میانگینهای پیشبینیشده در تابع احتمال پواسون استفاده میکنیم. p_all و p_book در رابطهٔ زیر، احتمال مشاهدهٔ تعداد مشخصی نتیجه در دو گروه هستند:
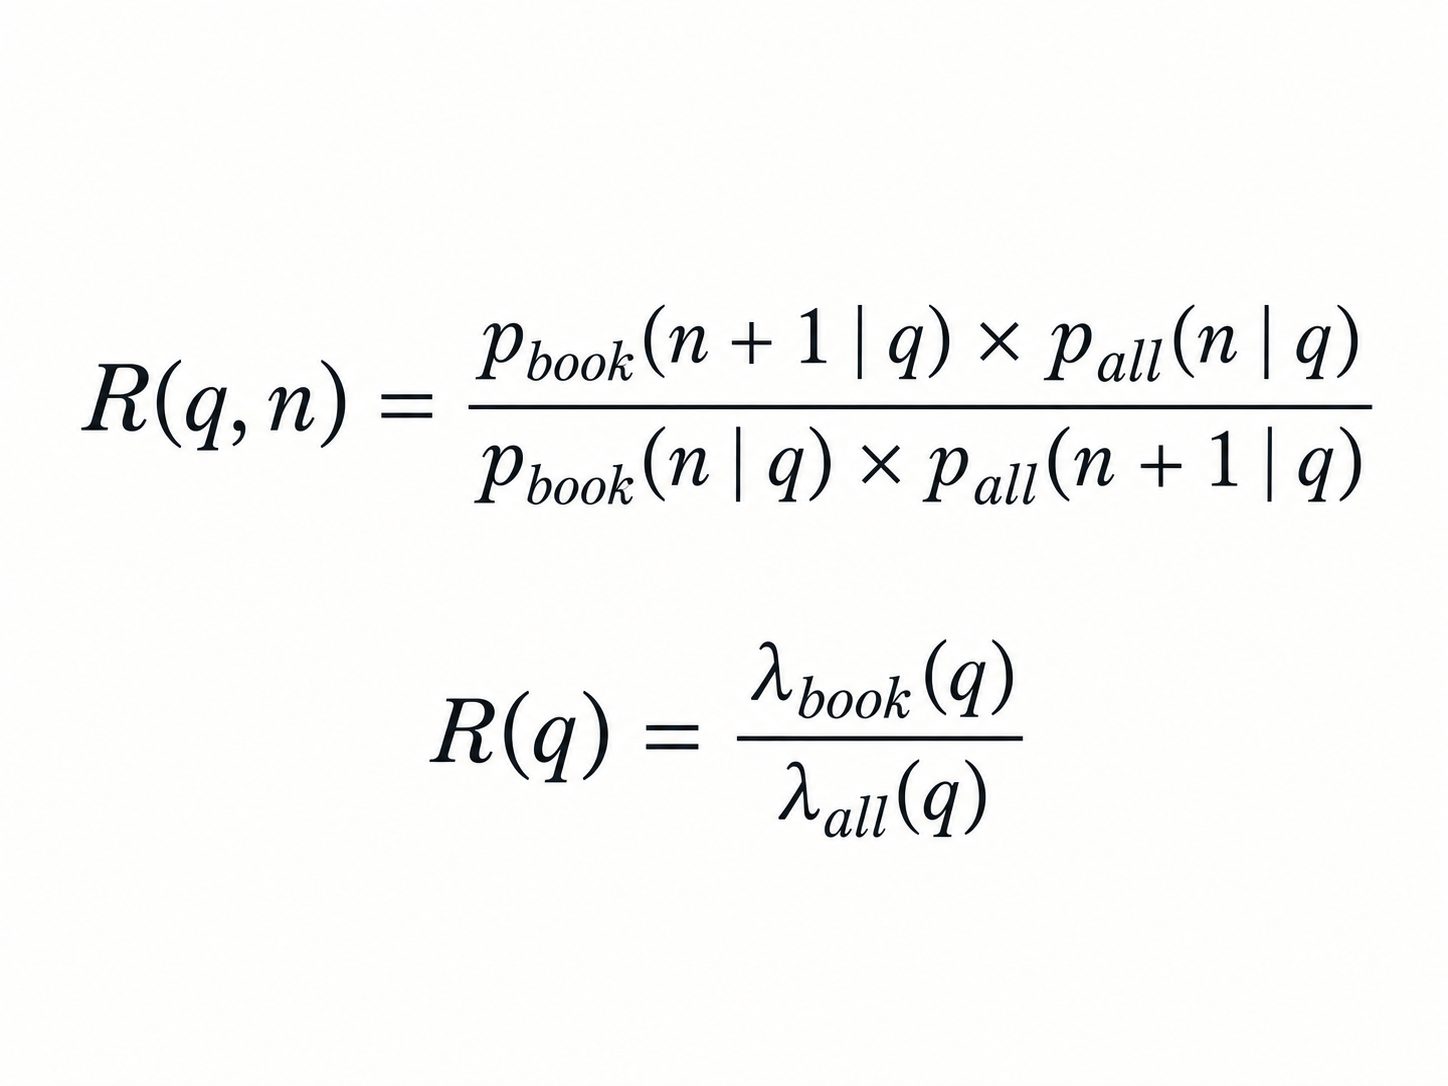
با ساده شدن رابطه، n حذف میشود. مثلاً اگر دو پیشبینی فرضی ۱۲ و ۱۸ باشند، R برابر ۱٫۵ است: میانگین پیشبینیشده برای گروه دارای نشانهٔ رزرو، ۱٫۵ برابر نمونهٔ عمومی است. این عدد به معنی ۵۰ درصد افزایش رزرو با اضافه کردن یک اقامتگاه نیست. چون تعداد نتایج فعلی در نسبت نهایی باقی نمیماند، از آن تعداد اقامتگاه لازم برای رفع کمبود هم به دست نمیآید.
تجمیع و ارزیابی امتیاز
برای جمعبندی یک گروه، بخش مثبت لگاریتم R را روی جستوجوهای یکتای عضو آن جمع میکنیم. جستوجویی با R کوچکتر یا مساوی یک، در این جمع سهمی ندارد:
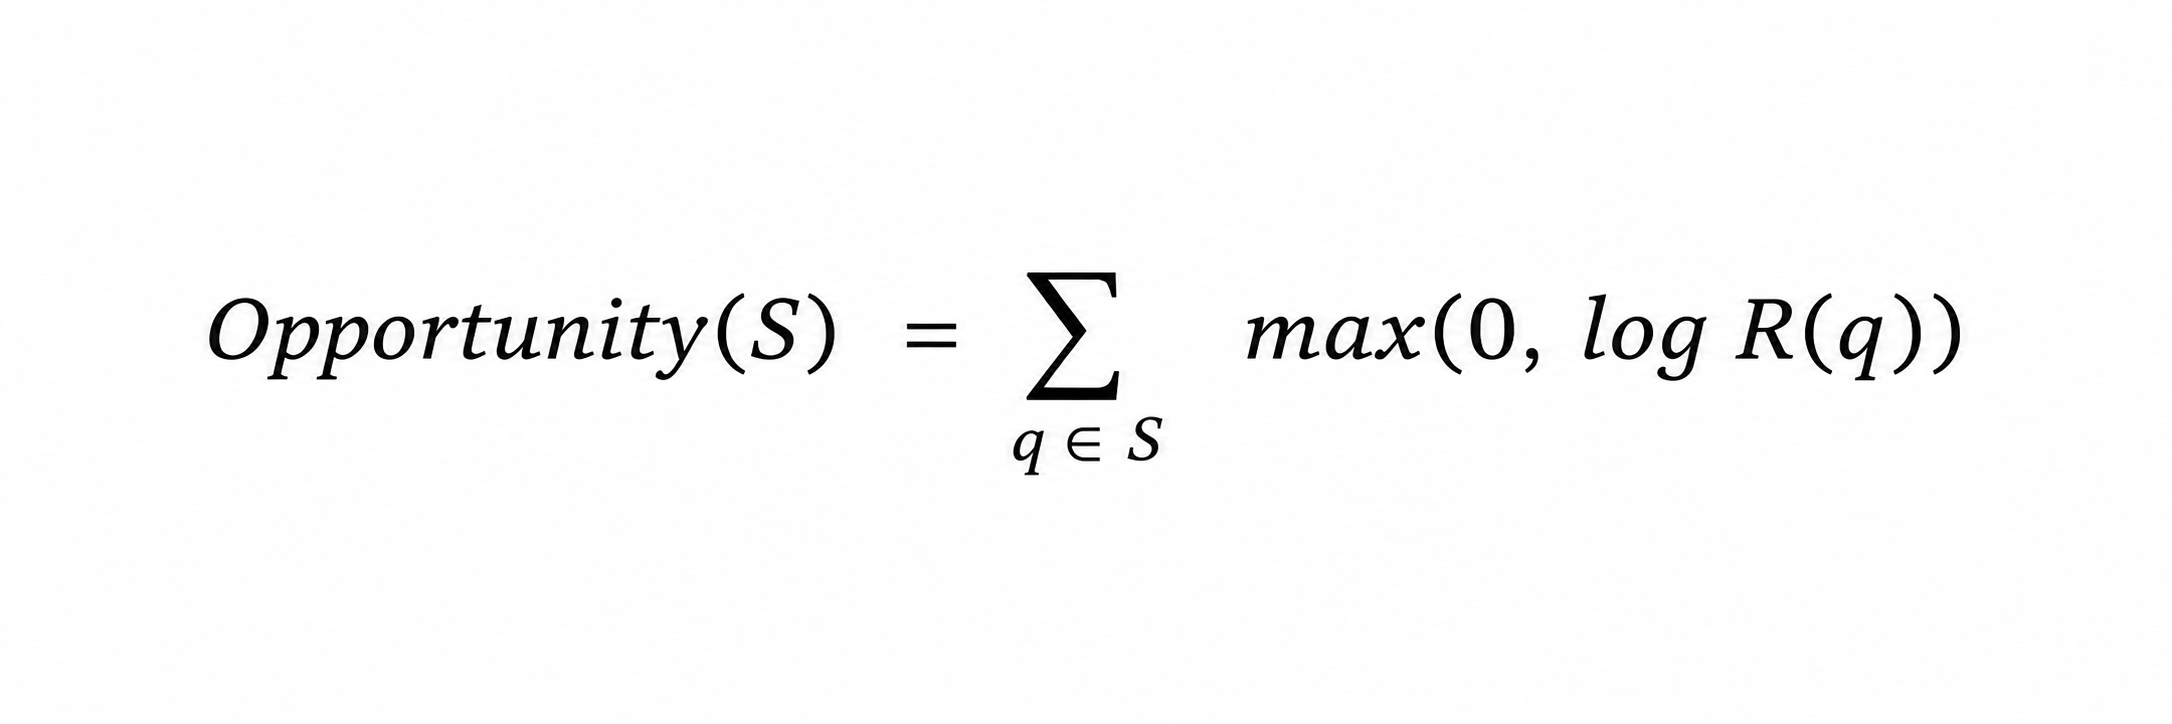
حجم تقاضا از قبل در این جمع اثر دارد؛ ضرب دوباره در تعداد جستوجو، آن را دوبار وارد محاسبه میکند. برای مقایسهٔ گروههایی با تعداد جستوجوی متفاوت، میانگین امتیاز هر جستوجو را هم میتوان در کنار مجموع گزارش کرد. مجموع، حجم و شدت را با هم بازتاب میدهد؛ میانگین، مقایسهٔ شدت امتیاز را آسانتر میکند. هیچکدام تعداد رزرو پیشبینیشده نیستند.
ارزیابی باید با دادههای جدا از آموزش، ترجیحاً از دورهای بعد، انجام شود. خطای پیشبینی تعداد نتایج، کفایت دادهٔ هر گروه و پایداری اولویتها با تغییر آستانه، بررسیهای متفاوتیاند. استفاده از زیان پواسون هم بهتنهایی درستی فرض توزیع را ثابت نمیکند؛ برای تفسیر احتمالها باید پراکندگی تعداد نتایج و فراوانی صفرها در جستوجوهایی با مشخصات مشابه بررسی شود.
در این مقاله، نمودارها فقط روش را توضیح میدهند و گزارش چنین ارزیابیای نیستند. برای نسبت دادن افزایش رزرو به افزودن عرضه، به ارزیابی علّی جداگانه نیاز داریم.